
SANTA MONICA / LONDON (IT BOLTWISE) – Eine systematische Übersichtsarbeit sichtet 65 Fragebogen zur Messung von Männlichkeit und findet eine klare Schieflage: 78 % der Instrumente sind auf Defizite und problematische Ergebnisse ausgerichtet. Gleichzeitig berücksichtigen viele Skalen soziale Beziehungen nur unzureichend; bei 43 % bleibt der Bezug zu Kontext und Mitmenschen niedrig. Auch kulturelle Passung gelingt nur selten, denn 58 % der Tests beziehen kulturelle Normen gar nicht ein. Die Autoren sehen darin eine wichtige Ursache, warum sich Antworten oft schwer in alltagsnahe Bedeutungen übertragen lassen.
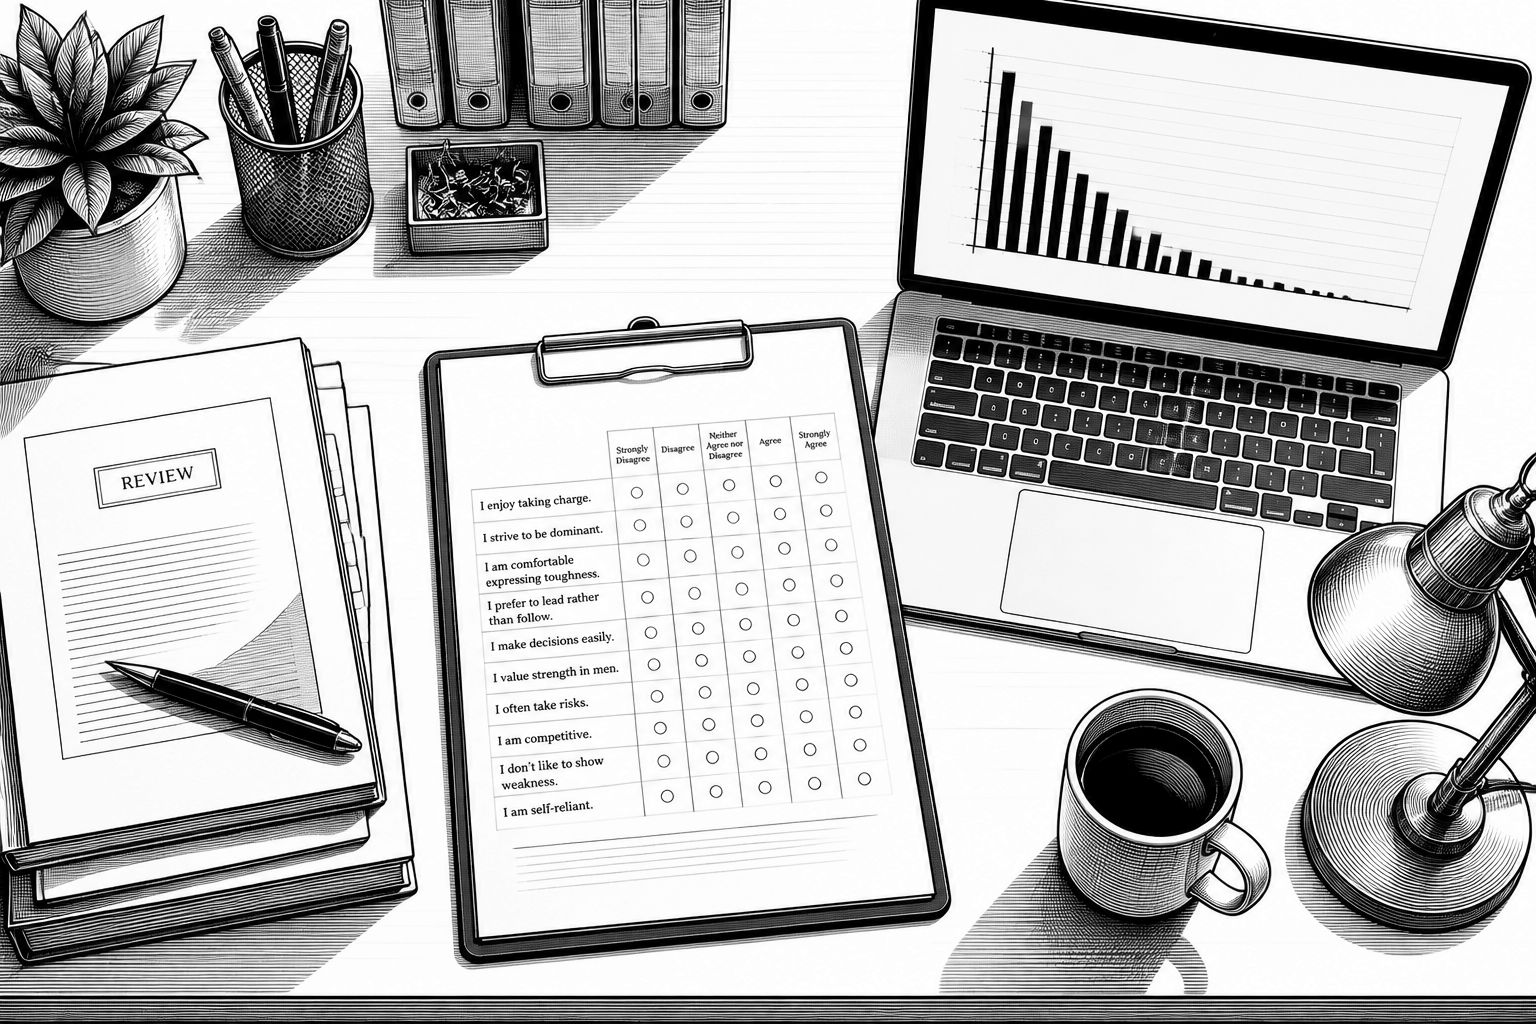
Wer Männlichkeit in der psychologischen Forschung messen will, startet meist mit standardisierten Fragebögen. Die neue systematische Scoping-Review verschiebt dabei den Fokus von der Frage „Was ist Männlichkeit?“ hin zu „Wie wird Männlichkeit überhaupt operationalisiert?“. Betrachtet wurden 65 Messinstrumente, die zwischen 1974 und 2021 entwickelt oder genutzt wurden und auf quantitativen Skalen beruhen. Das Ergebnis ist weniger ein Urteil über „richtige“ oder „falsche“ Männlichkeit, sondern eine Datenspur darüber, welche Art von Antwortmuster die Werkzeuge besonders wahrscheinlich erzeugen.
Technisch handelt es sich bei den Skalen um Zustimmungserhebungen, bei denen Teilnehmende Aussagen dazu bewerten, wie Männer denken, fühlen oder handeln „sollten“. Die Review zeichnet nach, wie sich diese Messlogik historisch verändert hat: Frühe Fragebögen aus den 1970er-Jahren behandelten Männlichkeit und Weiblichkeit eher als Persönlichkeitsdimensionen, also als Eigenschaften, die in unterschiedlichem Ausmaß bei Menschen vorkommen können. Seit den 1990er- und frühen 2000er-Jahren verschoben viele Instrumente ihren Schwerpunkt stärker auf die Einhaltung starrer sozialer Regeln, zum Beispiel emotionale Härte, Selbstständigkeit oder Dominanz. Für die Interpretation ist genau diese Verschiebung entscheidend: Wenn ein Fragebogen vor allem Konformität gegenüber Normen abfragt, wird „Männlichkeit“ automatisch als potenziell riskanter Faktor gerahmt.
Besonders deutlich wird das im Befund zur Defizitorientierung: 78 % der untersuchten Instrumente arbeiten deficit-basiert, also mit Items, die Männlichkeit konsistent über negative Verhaltensweisen oder schädliche Outcome-Logiken definieren. Die verbleibenden 22 % enthalten zwar zumindest teilweise strengths-basiertes Framing, der Schwellenwert für diese Kategorie war in der Review allerdings bewusst niedrig, sodass schon ein kleiner Anteil positiver Aussagen ausreichen konnte. Damit erklärt sich auch die Beobachtung, dass selbst unter den am häufigsten zitierten 12 Fragebögen drei Viertel deficit-orientiert bleiben. Inhaltlich stützen sich viele dieser Defizit-Skalen auf die Theorie der gender-role strain: Die Idee lautet, dass das Bemühen, eng gefasste (und teils widersprüchliche) Erwartungen an Männlichkeit zu erfüllen, psychische Belastung erzeugt und zudem das Umfeld negativ beeinflusst.
Gleichzeitig prüfen die Autorinnen und Autoren nicht nur „deficit vs. strengths“, sondern auch die Frage, wie stark Skalen den sozialen Kontext berücksichtigen. Bei 43 % ist die relational focus niedrig: Die Instruktionen und Items liefern Aussagen ohne klare Vorgabe, wessen Erwartungen oder welches soziale Setting Teilnehmende im Kopf haben sollen. Nur 35 % erreichen eine hohe relationale Einbettung, etwa indem ausdrücklich nach Erfahrungen mit Freunden oder Teamkameraden gefragt wird. Besonders auffällig: Unter den am stärksten zitierten Instrumenten fehlte bei der Hälfte jeglicher relationaler Fokus. Das ist nicht nur eine Detailfrage, sondern beeinflusst unmittelbar die Bedeutung von Skalenwerten. Wenn ein Test soziale Situationen ausblendet, kann derselbe numerische Wert je nach Lebensumfeld unterschiedliche Interpretationen nahelegen.
Auch kulturelle Passung fällt in der Review überwiegend knapp aus. Mehr als die Hälfte der Skalen (58 %) diskutiert oder berücksichtigt kulturelle Normen gar nicht und behandelt damit westliche Vorstellungen von Männlichkeit implizit als universell. Nur 15 % zeigen eine hohe cultural attunement. In der Validierungslogik spiegelt sich das in der Stichprobenarbeit: 66 % der Fragebögen wurden an homogenen Teilnehmendengruppen getestet. Bei den am häufigsten zitierten Skalen findet sich in der Review kein Fall, der kulturelle Normen berücksichtigt, und nur ein Instrument nutzt eine demografisch vielfältigere Stichprobe. Der zweite Schritt der Bewertung umfasst dann klassische Gütekriterien: interne Validität, Reliabilität und externe Validität. Die meisten Tests schneiden bei interner Genauigkeit und Konsistenz gut ab (59 % hohe Reliabilität, 77 % moderate oder hohe interne Validität), während externe Übertragbarkeit deutlich schwächer belegt ist: Nur 9 % liefern starke Hinweise auf externe Validität, und fast die Hälfte bietet wenig Evidenz dafür, dass sich Ergebnisse über die ursprünglichen Testgruppen hinaus generalisieren lassen.
Die Review vergleicht die Messinstrumente zudem über mehrere Jahrzehnte hinweg und prüft, ob sich die Lücken mit der Zeit verringert haben. Für externe Validität berichten die Autoren einen Anstieg von durchschnittlich 1,00 von 3 Punkten in den 1970er-Jahren auf 2,50 in den 2020er-Jahren. Bei der cultural attunement steigt der Wert im gleichen Zeitraum von 1,00 auf 2,25, wobei einer der beiden statistischen Tests dazu nicht signifikant war. Für die restlichen Kategorien – darunter Defizit- versus Strengths-Fokus, relational focus und sample diversity – zeigen sich keine statistisch signifikanten Verbesserungen. Interessant ist hier auch der Umgang mit Zitierhäufigkeit: Ältere Skalen haben schlicht länger Zeit, viele Nennungen zu sammeln. Dadurch kann das „Gesamtbild“ der Toolkit-Entwicklung verzerrt wirken, wenn man stark auf die Anzahl der Zitationen achtet.
In der Einordnung wird die zentrale Frage adressiert, ob diese Messpraxis eher ein Bild von „Problemen“ oder von „Wirklichkeit“ abbildet. Fisher und Kolleginnen und Kollegen argumentieren, dass mangelnder sozialer Kontext es erschwert, zu interpretieren, was hohe Scores im Alltag tatsächlich bedeuten. Parallel nehmen sie Defizit-Ansätze nicht aus der Verantwortung, sondern ordnen sie als nützlich ein, um Gesundheitsrisiken und Gewaltprävention zu untersuchen. Die Grenzen liegen vielmehr in der Kommunikation: Wenn öffentliche Gesundheitsbotschaften ausschließlich auf Schadenserzählungen setzen, könnten sich Teile der Zielgruppe defensiv verhalten. In der breiten Debatte bleibt zudem umstritten, ob strengths-basierte Skalen Männer konstruktiv erreichen, oder ob die Bezeichnung allgemeiner menschlicher Tugenden wie Mut oder Verantwortung als „männlich“ ungewollt binäre Geschlechterstereotype verstärkt.
Die Kritik an der einseitigen Messlogik wird auch in Originalzitaten aus der Fachwelt sichtbar. Laut einer kritischen Auseinandersetzung mit Männlichkeitsfragebögen bemängeln Beobachter, dass Items, die formulieren, wie ein „echter Mann“ sich verhalten soll, es schwer machen zu unterscheiden, ob Teilnehmende Normen lediglich erkennen, sie als wünschenswert bewerten oder als persönlichen Wert leben. Aus der Praxisperspektive formulieren Christian Blö tner und Sören Michallek, ebenfalls nicht an der Review beteiligt: „The most important takeaway is that most of those tools were designed to identify negative aspects or the problems associated with masculinity, “ heißt es in ihren Worten. „There is a dearth of assessment tools, however, that emphasize the potential strengths concomitant with masculinity.“ Sie verweisen außerdem auf ein übergreifendes Forschungsproblem: „If we know that adherence to traditional masculinity is harmful, how (if at all) should masculinity change?“ Ihre zweite Option lautet entsprechend entweder „degendering“ oder „multigendering“, also die Relevanz von Geschlecht zu reduzieren oder die Vielfalt innerhalb von Geschlechtern zu erweitern.
Für die nächste Forschungsrunde leiten die Autoren konkrete Anforderungen ab: Maßnahmen sollten stärker mit diversen Communities entwickelt und getestet werden, Instruktionen müssten den sozialen Kontext spezifizieren, und empirisch müsste geprüft werden, wie unterschiedliche Framing-Strategien die Bereitschaft von Männern beeinflussen, Angebote für Gesundheit und Beziehungen wahrzunehmen. Für Anwenderinnen und Anwender in Wissenschaft und Praxis ist die Kernbotschaft dabei relativ klar: Ein Skalenwert ist nicht nur eine psychologische Eigenschaft, sondern auch ein Spiegel der Messarchitektur. Wer Ergebnisse in Programmen, Beratung oder Präventionsarbeit verwertet, sollte deshalb stärker darauf achten, ob das Instrument Defizite in den Vordergrund stellt, sozialen Kontext abbildet und kulturelle Normen berücksichtigt – andernfalls wird aus der Statistik schnell eine zu enge Erzählung.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Masculinitäts-Tests: KI liefert in der Forschung noch zu wenig Kontext" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Masculinitäts-Tests: KI liefert in der Forschung noch zu wenig Kontext" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Masculinitäts-Tests: KI liefert in der Forschung noch zu wenig Kontext« bei Google Deutschland suchen, bei Bing oder Google News!