


LONDON (IT BOLTWISE) – OpenAI hat zwei neue Mainstream-Modelle angekündigt: GPT-6 Sol und GPT-6 Luna. Beide sollen bei identischen Anfragen rund halb so viele sachliche Fehler verursachen wie die vorherige Generation. Gleichzeitig sinken die API-Preise laut Unternehmen um 50 Prozent, während die günstigere Luna-Variante auf Kostenniveau zur Vorgängervariante aufschließen soll. In Benchmarks wie Automationbench und DeepSWE werden außerdem klare Kosten- und Qualitätsvorteile gegenüber bekannten Alternativen adressiert.
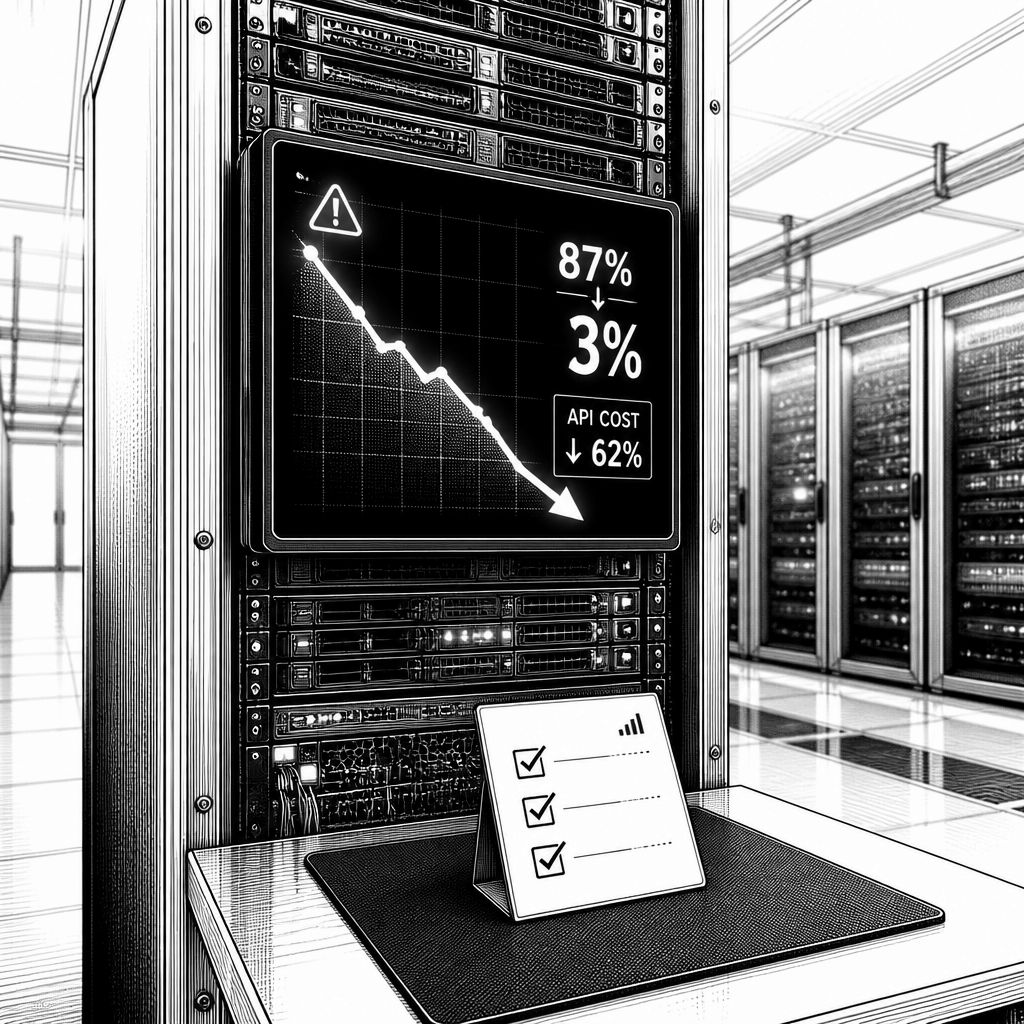
OpenAI positioniert GPT-6 Sol und GPT-6 Luna als pragmatische Weiterentwicklung für den Alltag in Unternehmen: weniger Halluzinationen, spürbar niedrigere Betriebskosten und Modelle, die sich ohne große Systemumstellung einführen lassen sollen. Entscheidend ist dabei die Kombination aus zwei Aussagen, die in der Praxis fast immer zusammengehören. Laut den Angaben des Herstellers soll GPT-6 bei identischen Anfragen etwa die Hälfte der sachlichen Fehler gegenüber der Vorgängerversion liefern, während die API-Preise im Vergleich zu GPT-5.6 um 50 Prozent sinken. Wer heute KI in Workflows einsetzt, kennt das Problem: Selbst wenn die Antwortqualität „meistens“ stimmt, müssen Unternehmen bei Fehlern nacharbeiten, prüfen oder zumindest mit zusätzlichen Kontrollschichten absichern.
Technisch bleibt der große Hebel in der Präsentation eher als Zielbild beschrieben, nicht als Architektur-Details. Trotzdem lässt sich aus der Logik der Kennzahlen ableiten, worauf es im Produktivbetrieb ankommt: Eine niedrigere Fehlerquote bedeutet, dass man weniger Zeit in Retries, Richtigstellungen und Quality-Gates investieren muss. Im Text wird das anhand eines konkreten Rechenbeispiels illustriert: Lag die Fehlerquote von GPT-5.6 Sol bei 20 Prozent, soll sie mit GPT-6 Sol auf rund 10 Prozent sinken. Die Hälfte-der-Fehler-in-Kombination-mit-Hälfte-der-Kosten ist für viele Teams relevant, weil sich dadurch nicht nur die reinen Kosten pro Token verändern, sondern auch die effektiven Kosten pro „korrektem Ergebnis“: Wenn ein Modell häufiger die erste korrekte Antwort liefert, sinken die durchschnittlich nötigen Abfragen.
Für die Einordnung in den Marktkontext ist zudem die Modellstaffelung zentral. GPT-6 Sol richtet sich offenbar an den Bereich „Performance zuerst“, während GPT-6 Luna als günstigere Variante die Kostenkurve weiter abflachen soll. OpenAI beschreibt, dass Luna mit GPT-5.6 Sol „gleichziehen“ soll, und zwar bei etwa einem Hundertstel der Kosten. Dieses Verhältnis ist im Unternehmensumfeld besonders interessant, weil es typischerweise die zweite Entscheidungsdimension nach Qualität adressiert: Welche Aufgaben laufen noch zuverlässig mit einem kleineren Budget? Häufig sind das Massen-Use-Cases wie erste Textklassifikation, Extraktion von Feldern, Vorschläge für Ticketbearbeitung oder das generative Zusammenfassen von Dokumenten, bei denen man nicht jede Ausgabe bis ins letzte Detail durch teure Modelle abdecken kann.
Beim Qualitätsvergleich spielt die angekündigte Benchmark-Story eine gewichtige Rolle, auch wenn der Text gleichzeitig einräumt, dass einzelne Daten nicht vollständig und damit nur begrenzt vergleichbar seien. In der Benchmark Automationbench soll GPT-6 Luna GPT-5.6 um 5,4 Prozent schlagen und dabei laut Angaben 58 Prozent geringere Kosten verursachen. Sol wiederum habe gegenüber Anthropic Claude Opus 5 um 6,3 Prozent besser abgeschnitten. Gerade diese Art von Darstellung ist für CTOs und Produktverantwortliche nützlich, weil sie nicht nur einen absoluten Score präsentiert, sondern den Trade-off zwischen Leistung und Kosten. Bei Coding- und Software-Engineering-Tests fällt die Aussage allerdings zurückhaltender aus: Dort werden Ergebnisse eher als „nahe am Spitzenwert“ oder „vergleichbar“ formuliert, statt harte Spitzenpositionen überall zu belegen.
Ein konkretes Beispiel aus dem Software-Engineering-Kontext ist DeepSWE: OpenAI zufolge habe GPT-6 Sol knapp an den Spitzenwert von Claude Fable 5 herangereicht, bei rund 80 Prozent niedrigeren Kosten. Luna soll bei mittlerer Rechenstufe vergleichbare Werte wie Opus 5 und Fable 5 erreichen, ebenfalls zu einem „Bruchteil des Preises“. Außerdem hebt OpenAI laut der Darstellung die bessere Ausdrucksweise hervor: Die Modelle sollen klarer antworten und weniger Fachjargon verwenden. Das klingt auf den ersten Blick nach reiner UX-Frage, kann aber in der Praxis auch die Integrationsqualität beeinflussen. Weniger unnötige Terminologie reduziert die Wahrscheinlichkeit, dass nachgelagerte Systeme (zum Beispiel Extraktion, Regelprüfung oder Guardrails) an unerwarteten Formulierungen scheitern.
Aus Sicht der Implementierung sind solche Verbesserungen vor allem dann wirksam, wenn sie in ein Kosten- und Qualitätsmanagement übersetzt werden. Senkt ein Modell die Fehlerquote von 20 auf etwa 10 Prozent, dann verschiebt sich die optimale Strategie oft von „immer dasselbe Modell“ hin zu dynamischer Auswahl: teurere Modelle für kritische Pfade, günstigere für Vorstufen. Genau hier kann Luna als Einstiegspunkt dienen, während Sol die Fälle übernimmt, die stärkere Schlussfolgerungen oder robustere Begründungsarbeit erfordern. Für Teams mit vorhandenen Prompt- und Auswertungspipelines ist das zudem ein Signal, dass sich die Parameterjustierung und die Testabdeckung neu lohnt: Wenn sich Fehlerprofile und Kostenstruktur ändern, müssen auch die Härtungsmaßnahmen (z. B. automatische Plausibilisierung, Zitations- oder Faktenprüfungen, stichprobenartige Validierung) angepasst werden.
Wie bewertbar die Benchmark-Versprechen im Detail sind, bleibt natürlich eine Frage der Methodik und der Vergleichbarkeit. Der Text deutet an, dass nicht jede veröffentlichte Kennzahl vollständig verfügbar ist; das ist ein Hinweis darauf, Benchmarks nicht blind als endgültiges Urteil zu nehmen, sondern als Signal für das Kosten-Leistungs-Verhältnis. Unterm Strich ist die Richtung jedoch klar: OpenAI versucht, die nächsten Modellgenerationen nicht nur über abstrakte Leistungssteigerungen zu verkaufen, sondern über eine messbare Reduktion von Fehlern und einen aggressiven Preishebel gegenüber GPT-5.6. Für Unternehmen heißt das: Wer KI produktiv nutzt, bekommt durch GPT-6 potenziell mehr verlässliche Ergebnisse bei gleichzeitig geringeren Ausgaben – und sollte jetzt prüfen, welche Teile der eigenen Workflows vom niedrigeren Fehlerniveau und der Kostenstaffelung besonders stark profitieren.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "OpenAI stellt GPT-6 Sol und GPT-6 Luna vor: weniger Fehler, niedrigere Preise" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "OpenAI stellt GPT-6 Sol und GPT-6 Luna vor: weniger Fehler, niedrigere Preise" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »OpenAI stellt GPT-6 Sol und GPT-6 Luna vor: weniger Fehler, niedrigere Preise« bei Google Deutschland suchen, bei Bing oder Google News!