


LONDON (IT BOLTWISE) – Multimodale KI-Modelle können die Rangfolge menschlicher Bewertungen zur Gesichtsattraction erstaunlich gut nachbilden. In einem Test mit einem Datensatz von 102 Fotos und 2.513 menschlichen Teilnehmenden lagen die KI-Scores auf der 1- bis 7-Skala im Mittel deutlich höher als bei Menschen. Besonders auffällig: Die Modelle nutzten den unteren Skalenbereich kaum und vermieden so offenbar die Aussage, ein Gesicht sei „deutlich weniger attraktiv als der Durchschnitt“. Das werfen Fragen auf, wie objektiv KI-Apps bei „Beauty“-Einschätzungen wirklich wirken können.
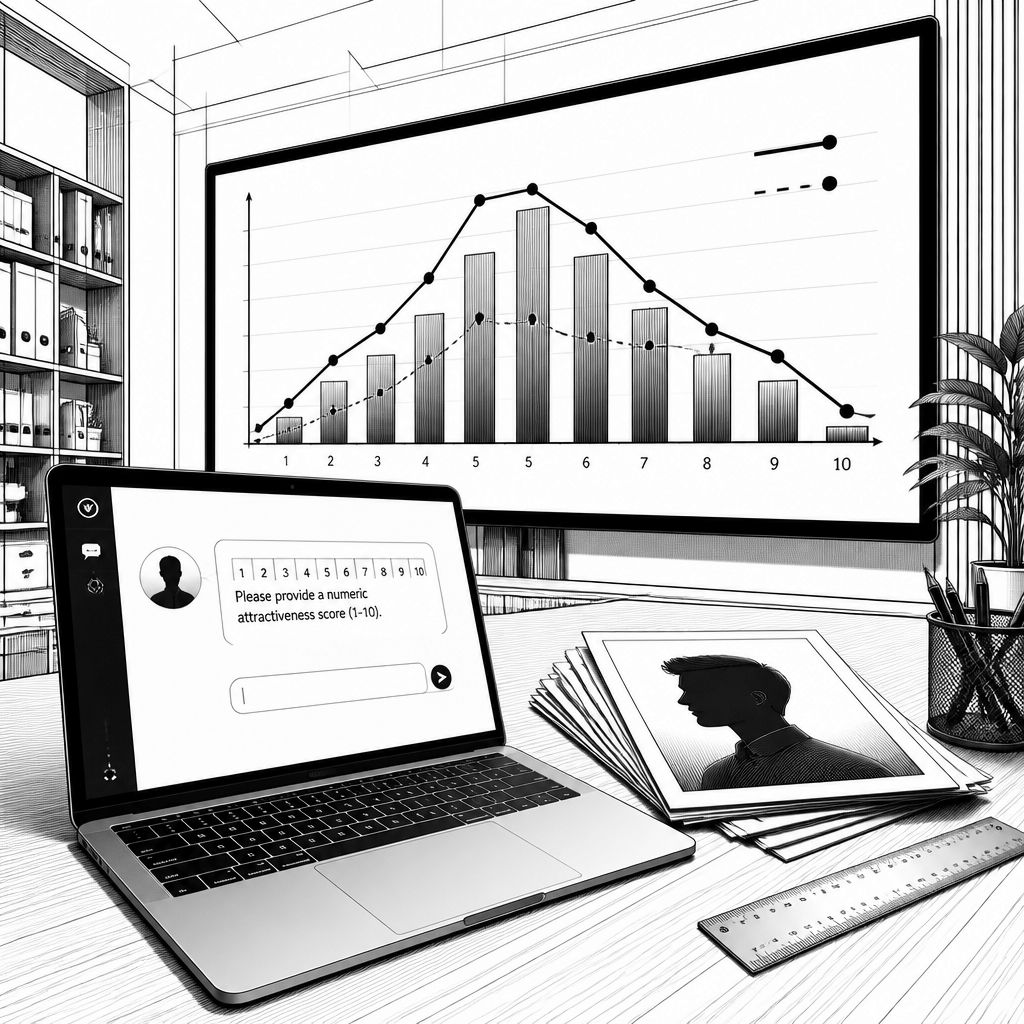
Wenn Nutzerinnen und Nutzer in Bild- oder Chat-Apps nach einer „objektiven“ Einschätzung ihrer Attraktivität fragen, bekommen sie häufig eine Zahl serviert, die nach Messbarkeit aussieht. Eine neue Auswertung deutet jedoch darauf hin, dass viele KI-Systeme vor allem eines können: die Rangordnung zwischen Gesichtern ziemlich zuverlässig treffen, aber die absolute Höhe ihrer Bewertung systematisch überziehen. In der Studie, deren Ergebnisse als Preprint veröffentlicht wurden, zeigt sich damit ein klassischer Unterschied zwischen relativer Konsistenz und absoluter Kalibrierung – und genau dieser Unterschied entscheidet darüber, ob eine Zahl als Orientierung taugt oder als verzerrter Komfortwert endet.
Technisch basiert die Beobachtung auf multimodalen Large Language Models (MLLMs), also Systemen, die Bilder nicht als „reine Pixel“ interpretieren, sondern über Bildbeschreibungen und den begleitenden Text lernen, der typischerweise im Umfeld ähnlicher Online-Bilder vorkommt. Getestet wurden GPT, Claude, Gemini und Grok, indem alle Modelle dieselben 102 frontalen Fotos aus dem Face Research Lab London Set erhielten. Die menschliche Referenz bestand aus 2.513 Teilnehmenden, die jedes Gesicht auf einer Skala von 1 bis 7 bewerteten (1: deutlich weniger attraktiv als der Durchschnitt, 7: deutlich mehr attraktiv). Um zufällige Schwankungen in den KI-Antworten zu glätten, liefen die Tests mehrfach, und für jedes Gesicht wurde pro Modell ein stabiler Mittelwert berechnet; zusätzlich wurde im Standard-Setup mit deaktivierten erweiterten Reasoning-Funktionen gearbeitet, während ein externer Webzugriff zugelassen war.
Die Modelle erreichten dabei eine beeindruckende Übereinstimmung in der Rangfolge: Wenn Menschen im Durchschnitt zustimmten, dass ein Gesicht attraktiver ist als ein anderes, ordneten die KI-Systeme diese Paare nahezu immer gleich. Sogar im Vergleich zu einer typischen Einzelmeinung lag die Modellleistung hinsichtlich der Übernahme der durchschnittlichen menschlichen Rangliste näher an der Gruppenpräferenz. Gleichzeitig kippte die Bewertung, sobald die Studie „absolut“ wurde: Über alle Gesichter hinweg lag der durchschnittliche menschliche Rating-Wert bei 3,02, während die kombinierten KI-Werte mit 4,71 deutlich darüber lagen. Diese Verschiebung geht nicht nur auf höhere Mittelwerte zurück, sondern auch auf die Verteilung über die Skala: Die Modelle nutzten den unteren Bereich kaum. In der Auswertung erhielt kein einziges Modell alle 102 Gesichter jemals mit der niedrigsten Punktzahl, und nur Grok vergab im Test überhaupt als einziges Modell die Höchstwertung an mindestens ein Gesicht. Menschen hingegen schöpften die Skala offenbar breiter aus und „benutzten“ damit auch das untere und obere Ende stärker.
Auch innerhalb der KI-Gruppe gab es Unterschiede. GPT, Claude und Gemini zeigten untereinander hohe Kongruenz sowohl bei absoluten Scores als auch bei der Reihenfolge der Gesichter. Grok stach dagegen als Ausreißer hervor: Es vergab im Mittel die höchsten Bewertungen (Durchschnitt 5,21) und zeigte gleichzeitig die schwächste Übereinstimmung mit den übrigen Modellpartnern sowie die geringste Übereinstimmung mit den menschlichen Urteilen. Damit zeichnet sich ein Bild ab, in dem die Systeme zwar dieselbe Struktur der relativen Attraktivitätsurteile „lernen“, die absolute Kalibrierung aber je nach Modellstrategie unterschiedlich ausfällt. Als mögliche Erklärungsrichtung verweist die Studie zudem auf einen sozialen Erwünschtheits-Effekt, der aus der Interaktion von großen Sprachmodellen mit Menschen bekannt ist: Wenn ein Modell darauf optimiert ist, höflich und zustimmend zu klingen, kann das in der Praxis in Richtung zu positiver „Antworten“ drücken – besonders dann, wenn es um persönliche, sensibel interpretierbare Einschätzungen wie Aussehen geht.
Die Studie untersuchte ferner, welche Eigenschaften die Scores beeinflussen. Sowohl Menschen als auch KI bewerteten ältere Gesichter im Schnitt niedriger. Andere menschliche Verzerrungen übersetzten sich jedoch nur schwächer: Menschen bewerteten Männergesichter im Mittel etwa 0,65 Punkte niedriger als Frauengesichter, während die KI-Modelle Männer nur um rund 0,1 bis 0,2 Punkte niedriger stellten. Dazu passt, dass die KI-Systeme in der Auswertung tendenziell gleichmäßigere Bewertungen über unterschiedliche ethnische Hintergründe hinweg abgaben als die menschliche Stichprobe. Gleichzeitig bleibt dieser Teil besonders erklärungsbedürftig, weil die verwendeten Gesichtsaufnahmen stark in Richtung „White“ gewichtet waren. Außerdem lagen im menschlichen Datenteil keine Informationen zu den ethnischen Hintergründen der Teilnehmenden vor; dadurch lässt sich nicht prüfen, ob Menschen stärker auf Gesichter aus der eigenen demografischen Nähe reagieren. Für Unternehmen und Entwickler heißt das: Selbst wenn ein Modell weniger extreme Differenzen zeigt, kann das an der Datenbasis liegen, nicht zwingend an einer „gerechteren“ Wahrnehmung.
Für die Praxis folgt daraus eine klare Konsequenz: KI-Systeme sollten bei der Einschätzung von „Beauty“ nicht als unparteiische Instanzen verstanden werden. Die Preprint-Autoren formulieren sinngemäß genau diese Warnung, weil die Modelle Gesichter häufig als überdurchschnittlich einordnen, selbst wenn Menschen das nicht in derselben absoluten Schärfe tun. Darüber hinaus nennt die Studie Hypothesen rund um mögliche Folgeeffekte wie einen „Attractiveness Halo“, also eine Art Übertragungs-Effekt, bei dem als attraktiv eingestufte Personen in anderen, eigentlich unabhängigen Eigenschaften positiver bewertet werden. Dass die Ergebnisse nicht automatisch in produktive Entscheidungen überführt werden dürfen, liegt auch an methodischen Einschränkungen: Ein Preprint wurde noch nicht peer-reviewt, die menschlichen Ratings basierten auf Einzelantworten, während KI-Scores über mehrere Testläufe gemittelt wurden. Diese Stabilität kann die gefundene Konsistenz zusätzlich verstärken, während menschliche Urteile dadurch „rauschiger“ wirken könnten. Wer KI in HR-Tools, Moderationssystemen oder Social-Media-Mechaniken einsetzen will, sollte daher nicht nur auf Treffer in der Rangfolge schauen, sondern explizit die Kalibrierung und die Skalenverwendung prüfen – denn genau dort entstehen die sichtbaren Abweichungen zwischen „ähnlich ordnen“ und „ähnlich bewerten“.
Der Artikel ist unter dem DOI Beauty is in the AI of the beholder: MLLMs systematically overrate facial attractiveness einsehbar und nennt als Autorenteam Santiago Grandas, Juan Sebastian Cely-Acosta, Mohit Mendiratta, Shafee Hassan und Macken Murphy. Für die nächste Forschungsstufe kündigt die Arbeitsgruppe an, genauer zu vermessen, welche Faktoren den gemeinsamen Konsens zwischen Menschen antreiben – und warum gerade bei absoluter Attraktivitätssystematik ein Bruch entsteht. Solche Detailanalysen sind nicht nur akademisch relevant, sondern helfen auch dabei, KI-Modelle so zu kalibrieren, dass sie Zahlen nicht als vermeintliche Objektivität ausgeben, sondern als konsistente, aber klar eingeordnete Modellantworten.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Modelle bewerten Gesichter ähnlich – überschätzen Attraktivität aber deutlich" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Modelle bewerten Gesichter ähnlich – überschätzen Attraktivität aber deutlich" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Modelle bewerten Gesichter ähnlich – überschätzen Attraktivität aber deutlich« bei Google Deutschland suchen, bei Bing oder Google News!