
LONDON (IT BOLTWISE) – Neue „Decision Models“ versetzen AI-SOC-Teams in die Lage, Alerts statt per Textgenerierung als feste Entscheidungen zu behandeln. Die Modelle liefern dabei nicht nur eine Klassifikation, sondern auch eine kalibrierte Wahrscheinlichkeit, die sich direkt in Schwellenwerte für Automatisierung übersetzen lässt. Entscheidend ist jedoch, dass die Eingangs- und Kontextdaten stimmen: Ohne forensische Evidenz und organisatorisches „Normal“ wird auch eine gut kalibrierte Ausgabe zu einer falschen Entscheidung. Für Sicherheitsverantwortliche verschiebt sich damit der Hebel von der Modellgröße hin zur Engineering-Qualität der Triage-Pipeline.
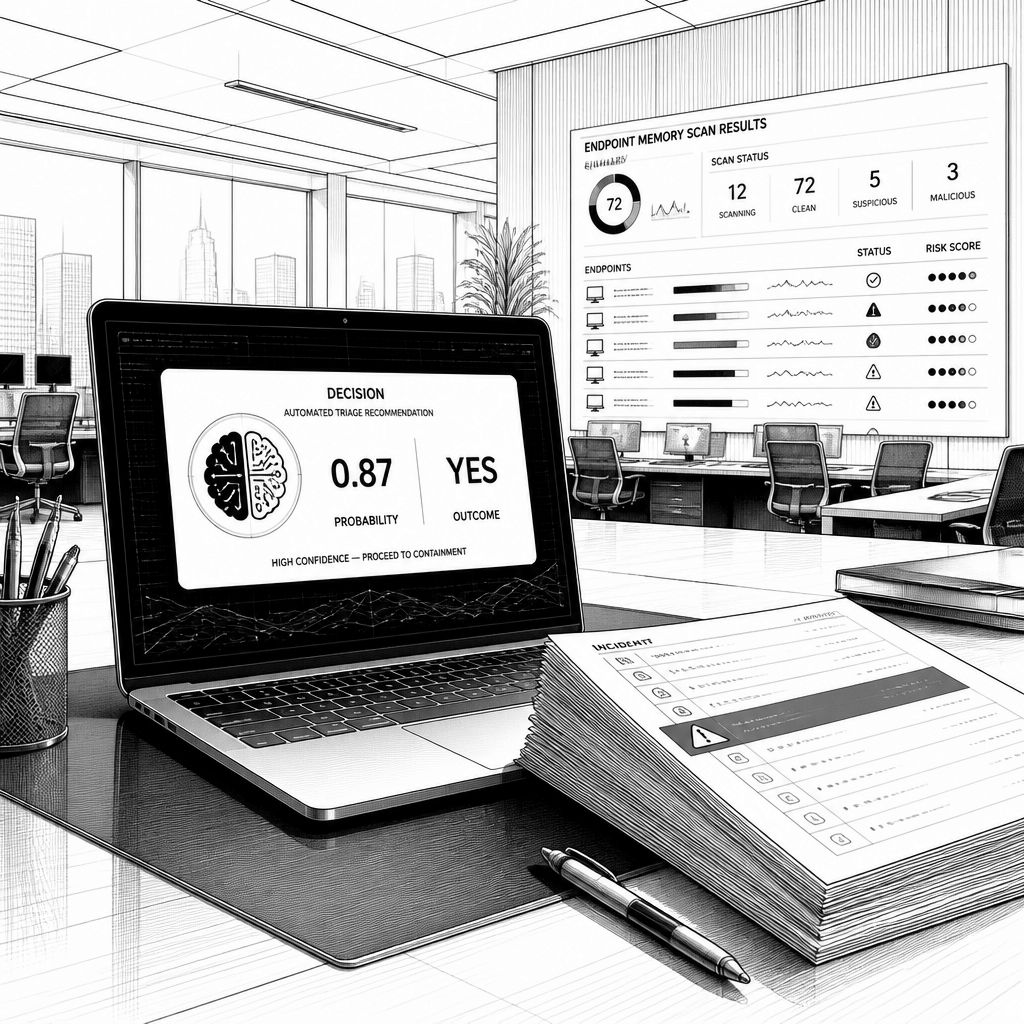
Innerhalb weniger Wochen hat sich rund um AI-SOC-Plattformen eine neue Modellgattung von „noch nicht da“ zu „überall“ bewegt: Decision Models. Der Kern ist vergleichsweise unaufgeregt, aber in der Praxis für Sicherheitsteams sehr wirkungsvoll. Die Modelle erzeugen keinen Fließtext und sie „räsonieren“ nicht als Absatz zur Problemstellung. Stattdessen erhält das System einen Status (zum Beispiel Ereignisfelder, Indikatoren oder strukturierte Befunde) und eine Menge typisierter Fragen. Als Antwort kommen eine Wahl aus einem vorgegebenen Satz, ein Score oder ein Ja/Nein mit einer Wahrscheinlichkeit. Genau diese feste Antwortform macht sie für Alert-Triage besonders attraktiv, weil Entscheidungen dadurch reproduzierbar und direkt in Workflows übersetzbar werden.
Warum das für die SOC-Praxis so gut passt, lässt sich an drei Eigenschaften festmachen. Erstens gibt es eine Zahl, gegen die sich Automatisierungen programmieren lassen. Zweitens liefert die Antwort einen typisierten Wert plus eine Wahrscheinlichkeit, die sich in Schwellen übersetzen lässt. Der Artikel beschreibt als Beispiel ein „Benign“-Prüfen über eine Wahrscheinlichkeit und schlägt vor, oberhalb eines hohen Werts automatisch zu schließen, während darunter eher eskaliert wird und der Zwischenbereich in eine Analystenprüfung fällt. Drittens eignet sich das Ergebnis als auditierbares Artefakt: Jede Entscheidung lässt sich loggen, wieder abspielen und mit dem späteren Ausgang vergleichen. Für die Compliance- und Qualitätsarbeit ist nicht die Frage „Kann das Modell gut formulieren?“ entscheidend, sondern „Ist die Entscheidung über Inputs hinweg stabil, nachvollziehbar und korrekt im statistischen Sinne?“
Damit stellt sich die zentrale technische Diskussion schnell auf die richtigen Ebenen: Kalibrierung versus Inhalt. Wenn Anbieter sagen, das Modell „könne nicht halluzinieren“, meinen sie meist nur, dass die Ausgabe dem vorgegebenen Schema entspricht. Ein wohldefinierter, formatkonformer Antwortsatz kann dennoch fachlich danebenliegen. Kalibrierung ist eine Aussage über Verteilungen, nicht über die konkrete Einzelinstanz. Der Artikel formuliert die Frage daher präzise: Was sieht „dieser Input“ im Vergleich zu den Trainings- oder Kalibrierungsdaten aus? Bei Alerts bedeutet das, dass die Wahrscheinlichkeit nur so aussagekräftig wird wie die Merkmale, mit denen das Modell „seinen“ Erwartungsraum definiert. Wer nur Alert-Titel und Severity als Eingabe verwendet, bekommt eine Kalibrierung für genau diese Art von Meldungen – aber nicht automatisch dafür, was auf einem bestimmten Host real „normal“ ist.
Genau hier wird der Unterschied zwischen Daten, die ein Modell zuverlässig interpretiert, und Kontext, der erst noch zusammengesetzt werden muss, besonders sichtbar. Der Artikel nimmt dafür eine eigene Datenbasis heran: In einer Auswertung über 25 Millionen Alerts aus 2025 wurden 82.000 Fälle per Live-Memory-Scan am Endpoint untersucht; davon zeigten 2.600 aktive Infektionen, und 51% dieser infizierten Maschinen waren bereits durch ein EDR-System als mitigiert gemeldet. Man kann sich die Konsequenz leicht vorstellen: Ein Decision Model, das nur den ursprünglichen Alert-Text und eine generische Severity sieht, kann die Erfolgsgeschichte oder die tatsächliche Kompromittierungslage verfehlen. Gleiches gilt bei identitäts- oder „Impossible Travel“-Signalen: In den Daten werden solche Alerts nur etwa zu 2% als echte Kompromittierung bestätigt, während andere Faktoren wie VPN-Nutzung sie häufig „benign“ erscheinen lassen. Das Problem ist weniger die mangelnde Rechenleistung am Entscheidungsende als das fehlende Wissen darüber, wie ein Unternehmen und seine Nutzer wirklich arbeiten.
Die Lösung wird im Artikel konsequent als Engineering-Loop beschrieben: Sicherheitskontext muss vor der Entscheidung gesammelt werden, und er muss sich laufend aktualisieren. Als Begriff nennt Filip Stojkovski „Security Context Engineering“; die Idee dahinter lautet, aus einem Alert erst ein Set belastbarer Fakten zu formen, bevor irgend ein Mensch oder ein Modell final entscheidet. Dazu gehört forensische Evidenz wie Prozessbäume, Parent-Informationen, vollständige Command Lines, Hashes und Reputation-Scores sowie Ergebnisse aus Detonation und Netzwerkforensik. Zusätzlich zählt der Blick auf den aktuellen Zustand: „Mitigated“ aus einem EDR ist nicht nur ein Feld, sondern ein Signal für den Status im Verlauf. Besonders wichtig ist der Hinweis auf In-Memory-Familien wie Mimikatz, Meterpreter oder Cobalt Strike: Wenn Angreifer gezielt im Speicher arbeiten, reicht die klassische Frage „Ist die Datei quarantined?“ oft nicht aus, weil relevante Artefakte fileless sein können. Für die Automatisierung entsteht damit eine harte Anforderung: Evidenz muss innerhalb kurzer Zeit für jeden Alert verfügbar werden, ohne dass das System aus Kostengründen bei vermeintlich „kleinen“ Meldungen aussetzt.
Genau an dieser Stelle argumentiert der Text auch wirtschaftlich: Das Auffüllen von Kontext ist der Teil, der traditionell manuell und teuer ist, während das letzte Entscheidungs-Update bei Decision Models sehr günstig und schnell sein kann. Im konkreten Beispiel werden je Modell nicht nur Kosten genannt, sondern auch Latenz: Jev wird mit 42 US-Dollar pro Milliarden Input Tokens verortet, Antworten in 70 bis 500 Millisekunden, wodurch sich auch große Alert-Volumina pro Jahr rechnerisch in eine „billige Entscheidung pro Meldung“-Kategorie schieben. Bei 450.000 Alerts pro Jahr und wenigen tausend Tokens je Alert verschiebt sich der Kostenfokus damit weg von „Sollte man nur bei High Severity prüfen?“ hin zu „Welche Evidenz und welches organisatorische Normalbild braucht die Entscheidung?“ Der Artikel nennt zudem eine klare Konsequenz für Auditierbarkeit: Wenn eine feste Antwort mit dokumentierter Wahrscheinlichkeit entsteht, lässt sich die gesamte Pipeline schärfer prüfen – und Drift erkennen, sobald sich die Verteilung der Inputs oder die Umgebung ändert.
Für Teams, die ihre eigene Triage-Pipeline bauen oder erweitern, ergibt sich daraus eine pragmatische Reihenfolge. Zuerst wird Evidenz gesammelt – etwa über Prozessbaum-Erfassung, Detonationsergebnisse und Memory-Inhalte, statt aus der Alert-Metadatenlage heraus zu entscheiden. Dann wird organisatorisches Wissen systematisch behandelt: Assets, Nutzerverhalten und „normal“ müssen kontinuierlich gelernt und aktualisiert werden, weil sich Infrastruktur, Routinen und Tooling wöchentlich verändern. Schließlich braucht es ein echtes Kalibrierungs-Measurement „im eigenen Umfeld“: Automatisierte Verdicts werden an ihrem späteren Ausgang festgemacht, die Wahrscheinlichkeitsschätzungen werden über Zeit überwacht und mit den tatsächlichen Trefferraten abgeglichen. Decision Models machen den letzten Schritt schnell, günstig und auditable – aber ob er richtig ist, hängt davon ab, wie gut die vorherigen Schichten die Beweislage und den Kontext vorbereiten.
Langfristig dürfte die Branche deshalb nicht primär über Modellrankings diskutieren, sondern über die Kontextschicht und die Prozess- und Evidenzintegration. Frontier-Modelle verbessern sich zwar regelmäßig, und Angreifer wie Wettbewerber profitieren von ähnlichen Updates. Die echte Differenz entsteht aber in den Datenpipelines: Welche Evidenzquellen werden pro Alert automatisch gezogen, wie schnell wird Live-Kontext nachgereicht, und wie konsequent wird aus vergangenen Fällen ein organisatorisches Gedächtnis aufgebaut? So wird die SOC-Arbeit schrittweise vom „informierten Gefühl“ des Analysts hin zu einem reproduzierbaren Entscheidungsprozess verschoben, der Risiken sichtbar macht, Wahrscheinlichkeiten nachvollziehbar macht und die Automatisierung auf eine statistisch fundierte Basis stellt.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Entscheidungsmodelle für AI-SOC: Alarm-Triage wird messbar und automatisierbar" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Entscheidungsmodelle für AI-SOC: Alarm-Triage wird messbar und automatisierbar" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Entscheidungsmodelle für AI-SOC: Alarm-Triage wird messbar und automatisierbar« bei Google Deutschland suchen, bei Bing oder Google News!