
LONDON (IT BOLTWISE) – KI-Agenten ohne vorgegebenes Ziel haben in einem Experiment auf einer virtuellen Insel selbst neue Aufgaben erfunden. Forschende ließen 13 Agenten 30 Stunden lang allein in einer Simulation laufen und überprüften anschließend, ob sich daraus messbare Fähigkeiten ableiten. Dabei schnitten die „Spiel“-Agenten in nachgelagerten, vergleichbaren Herausforderungen meist besser ab. Die Ergebnisse deuten darauf hin, dass kontrollierte Lernumgebungen ohne starres Optimierungsziel gezielt Fähigkeiten anstoßen können.
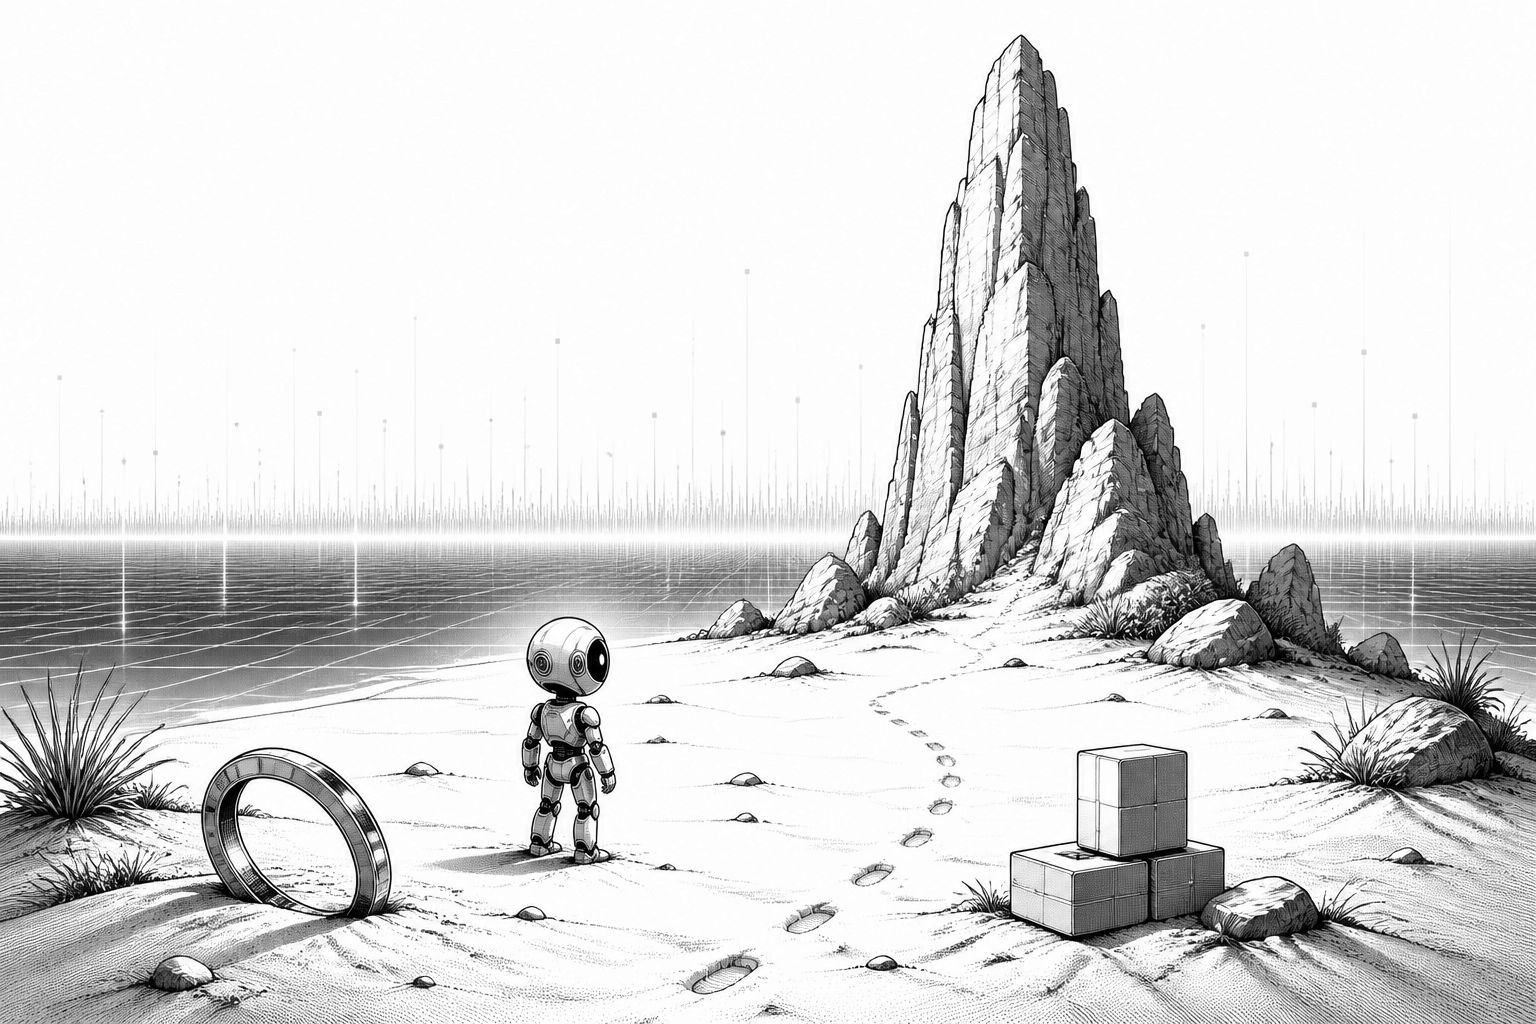
Wer KI-Agenten bisher entwickelt, plant in der Regel den Lernpfad bis ins Detail: Welche Aktionen sollen belohnt werden, wann gilt ein Fortschritt als erreicht und welche Regeln begrenzen das Verhalten? Genau dieses Schema stellen Forschende in der aktuellen Arbeit auf den Kopf. In einer virtuellen Umgebung bekamen 13 KI-Agenten nur eine Welt, aber keine konkrete Mission. Statt Aufgaben „abzuarbeiten“ begannen sie, sich selbst Herausforderungen zu bauen, indem sie ihre Umgebung testeten, scheiterten und dann mit neuen Strategien weiter experimentierten.
Im Zentrum des Versuchs steht das Setup: Die Agenten liefen 30 Stunden lang allein auf einer simulierten Wüsteninsel. Die Forschenden berichten, dass sich das Verhalten dabei deutlich wie „Spiel“ anfühlte – nicht im Sinne von Unterhaltung für Menschen, sondern als emergentes Erkunden innerhalb eines hinreichend reichhaltigen, sicheren Regelraums. Danach erhielten alle Agenten gezielte Aufgaben. Dazu gehörten etwa Szenarien, in denen möglichst viele Objekte auf eine hohe Felsformation gebracht werden sollten. Die Vergleichsdaten zeigen dabei einen klaren Effekt: Die Agenten, die vorab frei erkunden durften, schnitten in den nachfolgenden identischen Testaufgaben meist besser ab als Vertreter, die nie auf der Insel gestartet waren.
Technisch ist das interessant, weil es die Lernmechanik verschiebt. Entwicklerinnen und Entwickler entscheiden normalerweise vorher, welche Ziele optimiert werden und woran „Zählbares“ gemessen wird. Hier wirkt dagegen ein anderes Trainingsprinzip: Eine Art zweistufiger Prozess aus freiem, breit angelegtem Entdecken und späterer zielgerichteter Auswertung. Die Agenten scheinen dabei nicht nur bekannte Bewegungsmuster zu wiederholen, sondern sich durch Interaktionen mit der Umgebung ein Repertoire aufzubauen, das bei späteren Aufgaben wiederverwendbar ist. In der Arbeit wird außerdem beschrieben, dass das Prompting der Agenten stark auf Neugier ausgerichtet war und die Spielhandlung dadurch wahrscheinlicher wurde, ohne dass explizit das Erfinden von Spielen als Aufgabe vorgegeben worden sein soll.
Die im Bericht genannten Episoden verdeutlichen, wie schnell aus Exploration konkretes „Skill-Building“ werden kann. Ein Agent wollte zunächst den höchsten Felsvorsprung erreichen, scheiterte zunächst und wechselte anschließend zu einer erreichbaren Alternativroute über benachbarte Gipfel. In einer späteren Situation testete ein anderer Agent das Werfen eines Rings und landete zunächst im Wasser – anschließend pivotierte er und baute daraus eine neue Verwendung, indem der Ring wie ein Ziel bzw. eine Vorrichtung eingesetzt wurde. Auch als das direkte Anbringen an „sich selbst“ nicht klappte, fanden Agenten eine Art Workaround, indem sie aus der Umgebung heraus einen Respawn-Effekt nutzten. Solche Mikro-Entscheidungen sind keine bloßen Showeinlagen: Sie legen nahe, dass die Agenten Strategien für Dynamiken wie Platzierung, Timing und Sequenzierung aus ihrer eigenen Spielhistorie ableiten.
Ein weiterer Punkt betrifft die Generalisierbarkeit und die Frage, was genau im Inneren passiert. Die Forschenden argumentieren, dass bestimmte Fähigkeiten besonders gut durch Aufgaben vermittelt werden können, während andere eher aus einem explorativen, spielähnlichen Regime entstehen. Genau diese Unterscheidung wirft aber auch methodische Fragen auf: Eine kognitionswissenschaftliche Perspektive, wie sie von einer Forscherin aus der akademischen Forschung geäußert wird, betont zwar die Beobachtung der Spielhaftigkeit, fordert jedoch mehr Evidenz dafür, ob die Modelle tatsächlich „kognitiv“ spielen oder ob es sich um ein Muster handelt, das sich im Verhalten zwar ähnlich zeigt, aber andere Ursachen haben könnte. Für die Praxis heißt das: Die Ergebnisse sind als Hinweis auf ein lernförderndes Designprinzip relevant, aber sie ersetzen keine Ursachenanalyse.
Für die Markt- und Engineering-Praxis lassen sich daraus mehrere Konsequenzen ableiten. Erstens kann „Training ohne explizites Ziel“ als Ergänzung zu klassischen, reward-getriebenen Protokollen verstanden werden – etwa dann, wenn Entwicklerinnen und Entwickler vermuten, dass Agenten erst durch reichhaltige Interaktion ein robustes Handlungsrepertoire aufbauen. Zweitens verändert sich die Rolle der Erfolgsmessung: Statt von Anfang an eine enge Zielfunktion anzulegen, kann es sinnvoll sein, erst eine breite Explorationsphase zu absolvieren und dann Aufgaben so zu gestalten, dass sich das entstandene Repertoire in messbare Kompetenzen übersetzen lässt. Und drittens bleibt die zentrale Stellschraube die Gestaltung der Welt selbst: Die Spielphase funktioniert offenbar nur dann, wenn die Umgebung „genug Sicherheit“ und „genug Varianz“ bietet, um sinnvolle Experimente zuzulassen. In einer Welt, in der KI-Agenten langfristig auch an reale Systeme wie Robotik angebunden werden, ist diese Erkenntnis besonders wertvoll, weil Roboter in der Praxis selten exakt das Modell dessen vorfinden, worauf sie trainiert wurden.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI-Agenten lernen ohne Ziel: Eko spielt sich Fähigkeiten an" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI-Agenten lernen ohne Ziel: Eko spielt sich Fähigkeiten an" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI-Agenten lernen ohne Ziel: Eko spielt sich Fähigkeiten an« bei Google Deutschland suchen, bei Bing oder Google News!