
LONDON (IT BOLTWISE) – Eine fMRT-Untersuchung an der University of Melbourne zeigt, dass große Sprachmodelle Satzbedeutung nicht so repräsentieren wie das menschliche Gehirn. Entscheidend ist dabei, ob die Bedeutung über Wortreihenfolge und grammatische Rollen wie „wer tut was wem“ bestimmt wird. In Tests mit 5.778 Satzpaaren schneiden Modelle, die Rollen explizit strukturieren, deutlich besser ab als reine Wortvektor-Ansätze. Die Ergebnisse deuten darauf hin, dass KI-Grammatik zwar nutzbar ist, aber nicht zwangsläufig menschenähnliches „Verstehen“ abbildet.
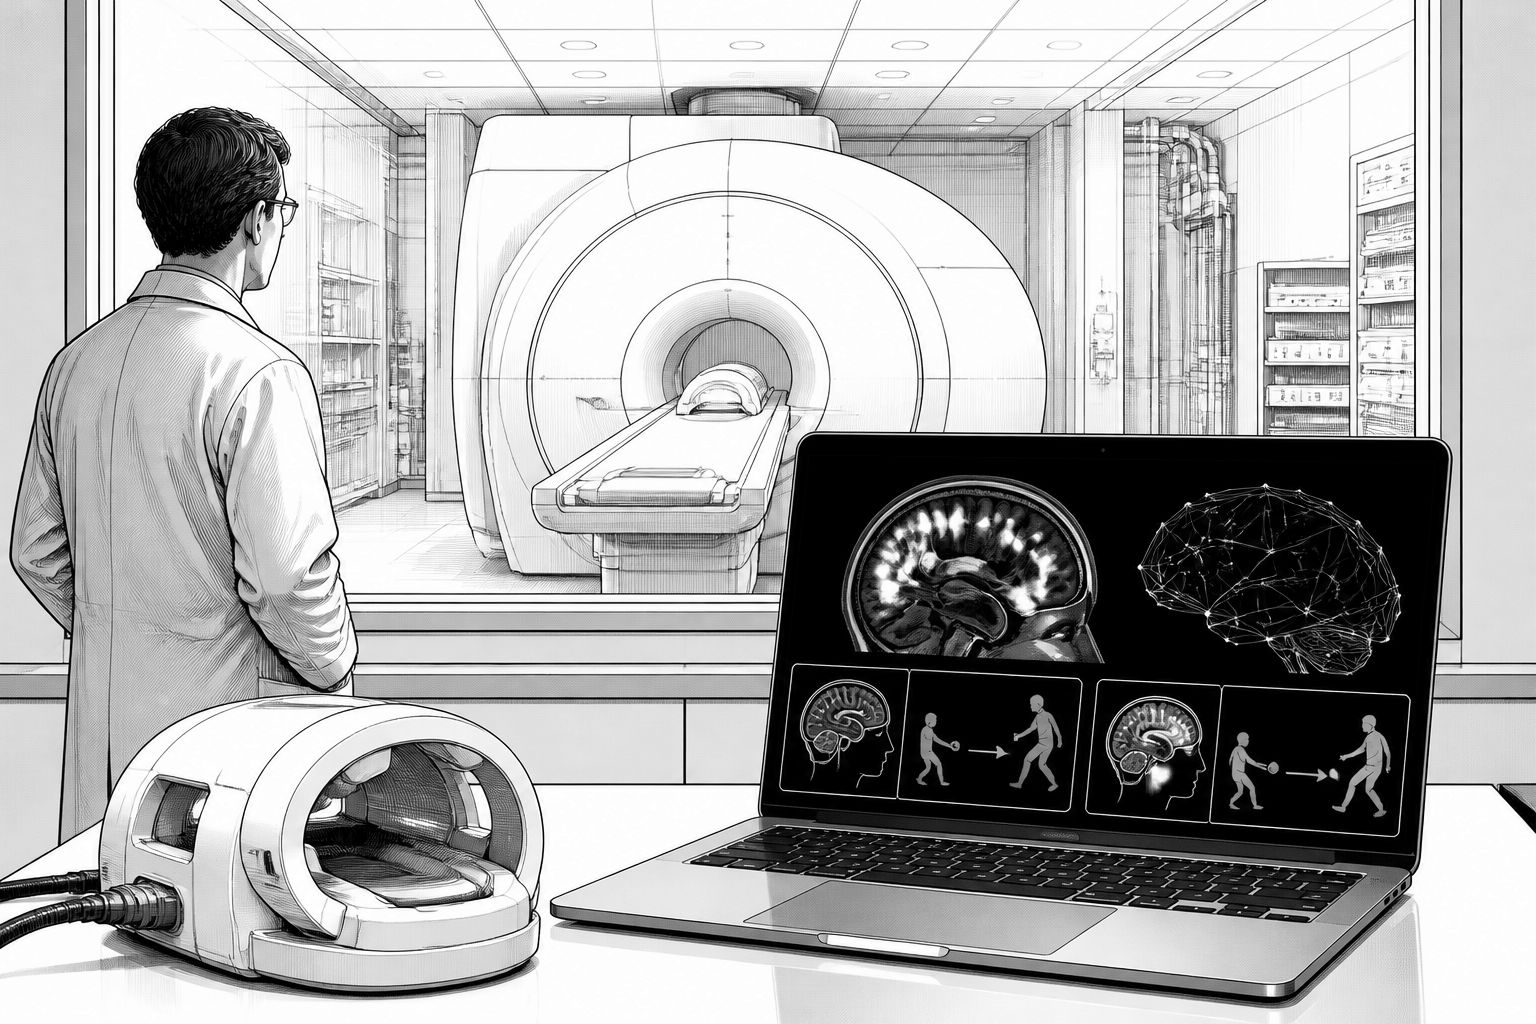
Dass moderne KI-Chatbots Grammatik in der Oberfläche meist beherrschen, ist inzwischen Alltag. Die neue Studie dreht die Fragestellung jedoch um: Nicht „kann ein Modell korrekte Sätze erzeugen?“, sondern „ordnet es Bedeutung ähnlich zur menschlichen Verarbeitung?“ Das Team um James Fodor nutzt dafür funktionelle Magnetresonanztomografie (fMRT) und vergleicht, wie Aktivitätsmuster im Sprachnetz des Gehirns zu unterschiedlichen Rechenmodellen passen. Im Zentrum steht dabei ein klassisches linguistisches Problem: Schon identische Wortlisten können je nach Reihenfolge eine andere Handlungsrolle erzeugen – etwa „der Kameramann bringt die Ausrüstung zum Regisseur“ versus „der Regisseur bringt den Kameramann zur Ausrüstung“.
Technisch betrachtet ist die Herausforderung für die Modellvergleichbarkeit ziemlich groß. Viele fMRT-Experimente verwenden natürliche Geschichten, in denen unterschiedliche Bedeutungen oft auch unterschiedliche Wörter mit sich bringen. Dann reicht es vielen KI-Embeddings aus, Vokabeln zu erkennen oder Mehrdeutigkeiten über statistische Muster grob aufzulösen. Genau diesen Mechanismus will die Arbeit abkoppeln: Die Forschenden entwerfen 108 Ein-Satz-Strukturen, lassen Variation gezielt über Adjektive sowie Zeit- und Ortsangaben entstehen und erzeugen zusätzlich „Role-swap“-Sätze, in denen Nomen die grammatischen Positionen tauschen, während die Wörter weitgehend dieselben bleiben. Damit wird die Unterscheidung zwischen Satzbedeutungen stärker eine Frage der Syntax und semantischen Rollen – also „wer ist Agens, wer ist Patient“ – statt der reinen Wortwahl.
Für die Gegenüberstellung wurden vier Modellklassen getestet, wobei zwei eher repräsentationsbasierte Vektoransätze nutzen und zwei explizit Struktur codieren. Als Baseline dient ein Wort-Ähnlichkeitsmodell, das Wörter mittelt und damit Wortreihenfolge ignoriert. Auf der Transformer-Seite betrachten die Autoren mehrere sentence-embedding-nahe Systeme sowie eine Kategorie-Aggregation über fünf Architekturvarianten, deren Einbettungen für den Abgleich mit Hirnmustern genutzt wurden. Die strukturbetonten Methoden gehen weiter: Ein graphbasiertes Modell ordnet Sätze als Abstract Meaning Representation (AMR) ab und vergleicht geteilte Teile anhand konkreter Subgraph-Ähnlichkeiten. Außerdem gibt es ein hybrides Vorgehen, das Wörter durch acht semantische Rollen taggt (unter anderem Verb, Agens, Patient, Zeit, Ort), getrennte Vektoren pro Rolle konstruiert und Rollen-Gewichte nutzt, die in einer vorherigen Arbeit der Gruppe erarbeitet wurden.
Die Messung erfolgte mit 39 englischsprachigen Probanden an einem 7-Tesla-fMRT-Scanner. Nach Ausschlüssen wegen Kopfbewegungen oder unzureichender Aufmerksamkeit (Start mit 39, am Ende 30 Personen) lasen die Teilnehmenden alle 108 Sätze viermal. Die Autoren analysieren jeweils die mittleren drei Sekunden pro Versuch, wobei eine Auswertung des späteren Fensters zu ähnlichen, aber schwächeren Ergebnissen führte. Entscheidend ist das Auswertungsprinzip: Mit representational similarity analysis wird nicht nur gefragt, ob ein Modell „ähnliche Wörter“ findet, sondern ob die Rangfolge von Satzpaaren – also welches Satzpaar für eine gegebene Modellrepräsentation näher liegt – zu den tatsächlichen Ähnlichkeitsstrukturen der Hirnaktivitäten im Sprachnetz passt. Insgesamt ergeben 5.778 Satzpaare einen breiten Abdeckungsgrad; davon sind 918 Paare innerhalb derselben Vokabel-Subsets so konzipiert, dass sie sich vor allem durch Wortrollen unterscheiden.
Die Resultate zeigen ein klares Muster, das vor allem an den Role-swap-Paaren sichtbar wird. Über alle Satzpaare hinweg zeigen alle vier Modelltypen positive Ausrichtung zum Sprachnetz, was zu erwarten ist, weil bei vielen Paaren ohnehin unterschiedliche Vokabeln vorkommen. In den individuellen Analysen über den Gesamtumfang ist der Unterschied zwischen dem einfachen Wort-Ähnlichkeitsmodell und den Transformer-Modellen jedoch statistisch nicht signifikant. Erst im strengeren Setting der 918 gleichen-Vokabel-Paare kippt das Bild: Das Wort-Ähnlichkeitsmodell fällt stark negativ aus, weil es role-getauschte Sätze als nahezu identisch bewertet, während das Gehirn sie als deutlich verschieden verarbeitet. Transformer-basierte Ansätze schneiden zwar besser ab als die Wort-Mittlung, zeigen aber weiterhin eine insgesamt negative Beziehung. Demgegenüber erreichen das hybride Rollenmodell und das graphbasierte AMR-Modell eine bescheidene, aber positive Ausrichtung auf genau diesen Role-swap-Paaren; beim Vergleich der beiden strukturbasierten Ansätze unterscheiden sich die Ergebnisse statistisch nicht signifikant.
Besonders aufschlussreich ist der Blick auf die Repräsentationsgeometrie: Transformer behandeln Role-swap-Sätze offenbar ähnlich wie Sätze, die nur Zeit- oder Ortszusätze ändern. Die strukturbetonten Modelle ordnen role-getauschte Paare dagegen „weiter auseinander“ ein, was die Richtung der Hirnähnlichkeiten besser trifft. Fodor formuliert den Kern der Interpretation in einer direkten Aussage: „We found evidence that LLMs process language differently to humans. This suggests that they may not ‘understand’ language in a fully human-like way.“ Gleichzeitig betonen die Autoren, dass Korrelationen in fMRT üblichweise klein sind – der Bericht nennt im selben-Vokabel-Subset Größenordnungen um etwa -0,05 für die Transformer-Aggregation und 0,07 für das hybride Rollenmodell. Diese Unterschiede seien aber nicht zufällig, sondern konsistent über Teilnehmende hinweg.
Über die Modellklassifikation hinaus liefern die Daten Hinweise auf mögliche Gründe. Die stärkste Übereinstimmung mit strukturierten Modellen findet das Team vor allem in temporalen Regionen des Sprachnetzwerks, obwohl sowohl frontale als auch zusätzliche Netzwerke (beispielsweise das Default Mode Network) ebenfalls reagieren. In Detailanalysen zeigen sich zudem Effekte, die mit Textoberfläche zusammenhängen könnten: Als sie visuelle Kortex-Aktivität kontrollieren, sinken selbst frühe Transformer-Schichtkorrelationen deutlich. Das stützt die Vorsicht der Autoren, dass fMRT-Alignment nicht automatisch gleichbedeutend mit einer menschenähnlichen semantischen Abbildung ist. Auch der ergänzende Online-Vergleich stützt differenzierte Lesarten: In einer Ratings-Studie passen Transformer und Wort-Mittlung über alle Paare im Schnitt gut zu menschlichen Similarity-Urteilen, aber innerhalb der gleichen-Vokabel-Subsets verliert die Wort-Mittlung stark, während das hybride Rollenmodell am besten zu den menschlichen Bewertungen passt.
Damit ordnet sich die Arbeit in ein Spannungsfeld ein: Sie steht im Widerspruch zu Interpretationen, die aus hohen Alignment-Scores sofort auf grammatisches Verstehen im menschlichen Sinne schließen. Fodor macht den praktischen Punkt ebenfalls klar: „Just because a computer model can perform a task to a human level, it doesn’t follow that the model is doing so in a human-like way. This can lead to unexpected behavior or failure modes when the model is deployed outside of the context in which it was trained.“ Gleichzeitig bleiben Einschränkungen: Die verwendeten Stimuli sind kontrollierte, relativ einfache Ein-Satz-Strukturen mit repetitiver Syntax, während echte Kommunikation über längere Zeit hinweg dynamisch Bedeutungen aufbaut. Die Autoren weisen außerdem darauf hin, dass Layer-Analysen bei einem Llama-3-Transformer nur in frühen Schichten positive Beziehungen zeigen und spätere Schichten eher negativ werden. Insgesamt lautet die Kernbotschaft für KI-Entwicklung und Evaluierung: Wenn die Aufgabe wirklich von Satzrollen und Wortreihenfolge abhängt, reichen Vokabel-Embeddings offenbar nicht; Modelle profitieren, sobald Repräsentationen explizite Struktursignale abbilden – und selbst dann bleibt „Wie menschenähnlich“ eine offene Frage.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "fMRT-Studie: LLMs erfassen Satzrollen nur begrenzt wie das menschliche Gehirn" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "fMRT-Studie: LLMs erfassen Satzrollen nur begrenzt wie das menschliche Gehirn" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »fMRT-Studie: LLMs erfassen Satzrollen nur begrenzt wie das menschliche Gehirn« bei Google Deutschland suchen, bei Bing oder Google News!