
LONDON (IT BOLTWISE) – Anthropic und Theorem haben bestehende OSS-Fuzz-Tests aus Googles OSS-Fuzz-Projekt in mathematische Spezifikationen übersetzt und damit Beweise für Absturzfreiheit erzeugt. Am 22. Oktober 2026 lieferte das System maschinell verifizierte Resultate für 239 Test-Einstiegspunkte in 123 Open-Source-Bibliotheken auf RISC-V-Assembly-Ebene. Die Nachweise gelten unter modellierten Bedingungen für Eingaben unter 64 Megabyte und für ein festes Speicherbudget. Gleichzeitig zeigen die Autoren Grenzen: Die Garantien beziehen sich auf statisch verknüpfte RISC-V-Programme mit musl, während x86/ARM und glibc nicht abgedeckt sind.
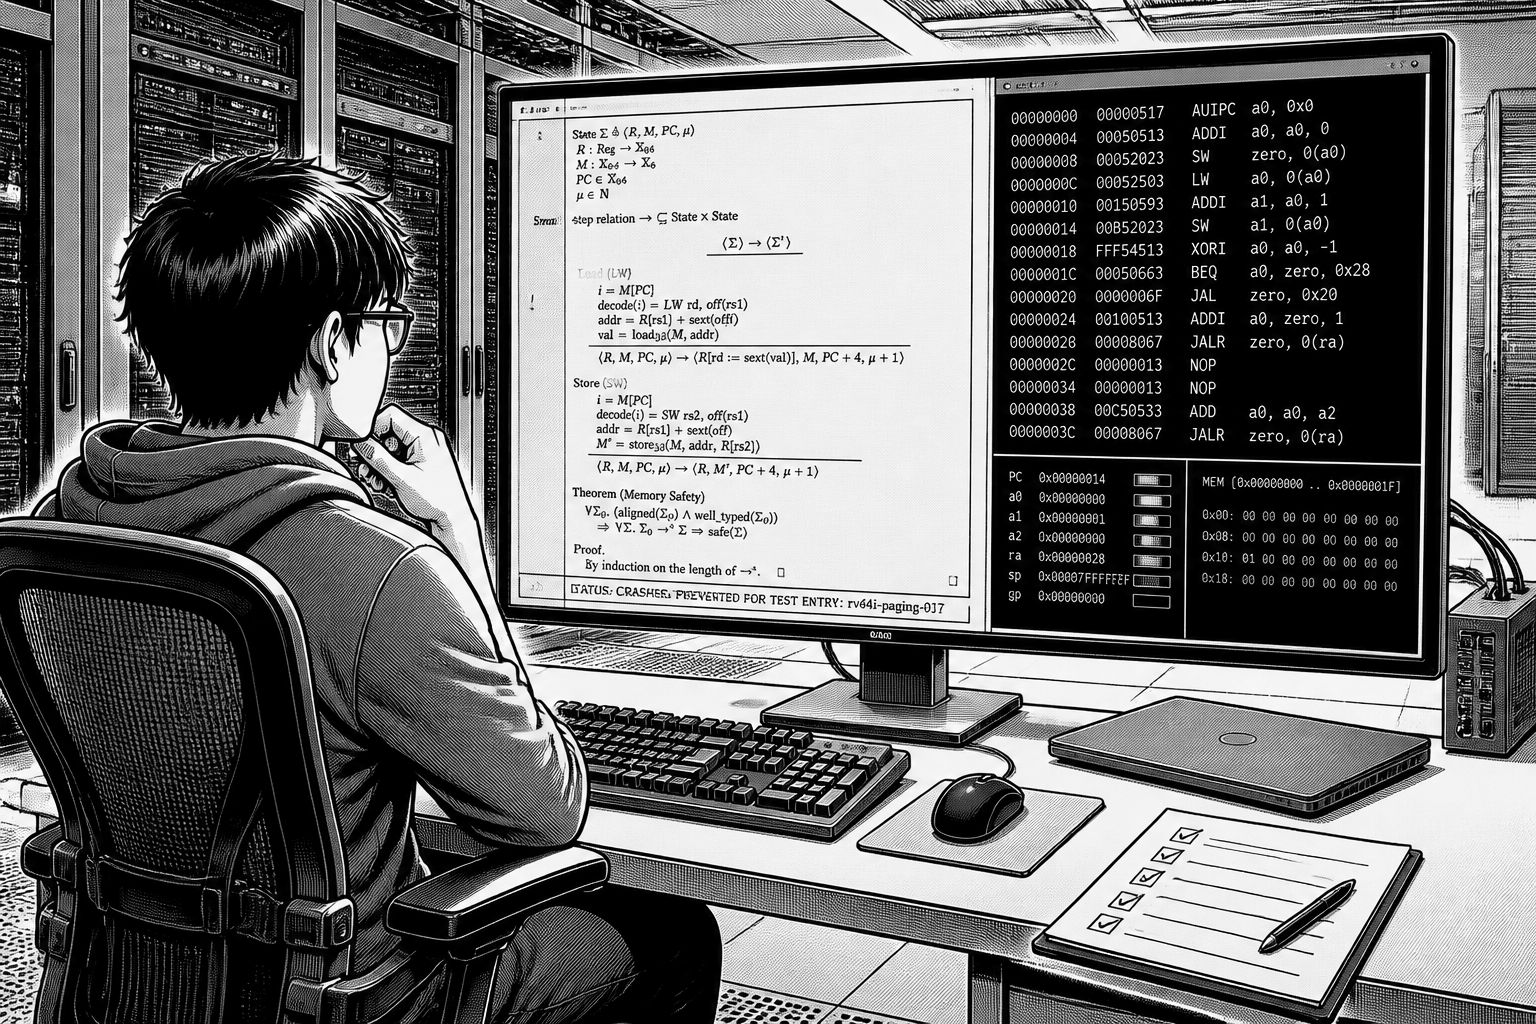
Der Schritt wirkt auf den ersten Blick wie ein typischer Fortschritt in der KI-gestützten Softwareanalyse. Tatsächlich verschiebt er aber den Schwerpunkt von „finden“ zu „zeigen“: Anthropic und das Verifikations-Startup Theorem haben Fuzz-Tests aus dem OSS-Fuzz-Ökosystem nicht nur angereichert oder automatisiert, sondern in mathematische Spezifikationen überführt, die sich in einem formalen Beweissystem prüfen lassen. Auf dieser Grundlage erstellte das System am 22. Oktober 2026 maschinell überprüfte Beweise zur Absturzfreiheit von 239 Einstiegspunkten in 123 Open-Source-Bibliotheken – und zwar auf RISC-V-Assembly-Ebene, also dort, wo sonst nur sehr grobe Annahmen über das Laufzeitverhalten dominieren.
Technisch basiert der Ansatz auf einer Kette, die mehrere Ebenen zusammenzieht: Die Übersetzung von bestehenden Fuzz-Tests in Spezifikationen dient als Brücke zwischen beobachtbarem Fehlverhalten (etwa Abstürzen im Testlauf) und überprüfbaren Eigenschaften (etwa „unter bestimmten Eingaben tritt kein bestimmter Klassenfehler auf“). In der Ausführung entstanden rund 180 Millionen Zeilen Beweiscode im formalen System Rocq. Die Größenordnung macht sichtbar, warum reine heuristische Methoden an Grenzen stoßen: Ein einzelner Beweis lag im Schnitt bei etwa 600.000 Zeilen, während die analysierten Binärdateien im Median rund 18.000 RISC-V-Befehle umfassten. Die Validierung übernahm ebenfalls Rocq, was die Ergebnisse für genau die Modellwelt nachvollziehbar macht, in der die Spezifikationen formalisiert wurden.
Im Prozess lief auch eine umfangreiche Fehlerbereinigung an, die über das hinausgeht, was klassische Fuzz-Workflows üblicherweise liefern. Laut den Angaben entdeckte Claude Hunderte Programmierfehler, die zuvor selbst bei extrem vielen automatisierten Testdurchläufen unbemerkt geblieben waren. Besonders greifbar ist der Beispielbefund vom 22. Oktober 2026: Ein Pufferüberlauf ließ sich auf einen Zähler-Unterlauf in einem Dekomprimierer zurückführen, der nur unter einem seltenen Speicherlayout auftrat. Dass gängige Fuzz-Tests meist nur Eingabegrößen bis etwa 1 Megabyte prüfen, während hier Eingaben unter 64 Megabyte als Geltungsrahmen dienten, erklärt zumindest teilweise die Lücke. Der Bericht beschreibt zudem Fälle wie einen unzulässigen Lesezugriff außerhalb von Speichergrenzen in einem Bild-Dekoder bei 64 Megabyte beziehungsweise über 2 Gigabyte Arbeitsspeicher sowie Abstürze durch eine Aufrufsequenz über zwei Dateideskriptoren auf dieselbe Datei; daneben werden nicht durchgesetzte Einschränkungen beim Dateizugriff genannt.
Die inhaltliche Tiefe zeigt sich jedoch erst an der Formulierung der Garantien. Unter modellierten Bedingungen belegen die mathematischen Nachweise laut Darstellung einen regulären Programmabbruch, das Ausbleiben fehlgeschlagener Zusicherungen sowie keine erkannten Speichersicherheitsfehler für Eingaben unter 64 Megabyte. Wichtig ist dabei die Präzision der Methodik: Es geht nicht um „globale Fehlerfreiheit“, sondern um das Zusammenspiel aus präziser Modellierung (RISC-V- und Linux-Semantik), formaler Spezifikation der untersuchten Eigenschaften und der Prüfung der resultierenden Beweise. Die Autoren nennen außerdem eine methodische Grenzenliste: Die Ergebnisse gelten ausschließlich für einsträngig ausgeführte, statisch verknüpfte RISC-V-Programme mit musl-C-Bibliothek in einer modellierten Linux-Umgebung bei festem Speicherbudget. Für gängige x86- oder ARM-Architekturen sowie für glibc lassen sich die Resultate nicht direkt übertragen.
Für den Markt ist das vor allem deshalb relevant, weil solche Beweise nicht nur die Sicherheitsabteilungen, sondern auch Entwicklungs- und Plattformteams tangieren. Das liegt weniger an der „Magie“ der KI, sondern an der Art, wie sich formale Verifikation in bestehenden Entwicklungsprozessen integrieren lässt. Theorem stellte am selben Tag eine Schnittstelle für Claude bereit und bietet eine Verifikationspipeline externen Projekten an; zusätzlich startete Theorem den kostenfreien Dienst „OSS Verify“ für Open-Source-Software. Gleichzeitig planen die Partner als nächste Schritte, die formale Überprüfung für weitere Komponenten voranzutreiben – etwa für den Paketmanager Nix inklusive glibc sowie für Bibliotheken wie OpenSSL und cURL. Wer solche Pfade heute einschätzt, muss parallel die Kosten- und Ressourcenfrage mitdenken: Anthropic bezifferte die Kosten eines einzelnen Beweises auf hunderte Millionen Token, während spätere Architekturen laut Bericht den Token-Verbrauch in Tests etwa durch effizientere Agentenaufteilung reduzieren konnten.
Damit stellt sich in Unternehmen weniger die Frage „Kann KI Beweise liefern?“, sondern „Welche Risiken kann ich mit Beweisen belegen und wo brauche ich weiterhin Tests?“. Gerade, weil Semantikmodellierung, Theoremaussagen und das Beweisprüfprogramm Restunsicherheiten enthalten können und weil Spezifikationen für AddressSanitizer nicht jeden denkbaren Speicherfehler erfassen, bleibt eine Lücke zwischen formaler Garantie im Modell und dem realen Verhalten in Produktion. Zusätzlich kommt der Kontext der EU-KI-Verordnung ins Spiel: Der Beitrag verknüpft die technische Diskussion mit einem Hinweis auf neue Pflichten und Fristen, die Unternehmen bei der KI-Nutzung im Blick behalten müssen. Für IT-Leiter heißt das praktisch: Sicherheits-Workflows sollten KI-gestützte Analyse und formale Prüfung als komplementäre Bausteine behandeln – und die Modellannahmen, unter denen Ergebnisse gelten, als Teil des Risikoprofils dokumentieren.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "KI verifiziert Absturzfreiheit: Claude beweist 239 Fuzz-Einstiege" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "KI verifiziert Absturzfreiheit: Claude beweist 239 Fuzz-Einstiege" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »KI verifiziert Absturzfreiheit: Claude beweist 239 Fuzz-Einstiege« bei Google Deutschland suchen, bei Bing oder Google News!