


LONDON (IT BOLTWISE) – Ein KI-gestütztes „World Model“ aus Stanford soll Rendezvous- und Proximity-Manöver für Raumfahrzeuge deutlich robuster machen. Statt starrer Regeln plant es per Simulation mehrere mögliche Zukunftsszenarien und steuert so Schritt für Schritt auf ein Ziel zu. Für das Training nutzt das Team GPU-beschleunigte Simulationen mit einer speziell angepassten Bibliothek namens AstroJAX. Erste Ergebnisse zeigen Lernfortschritte gegenüber klassischem Reinforcement Learning, gleichzeitig bleiben noch Einschränkungen bei der Treffergenauigkeit in bestimmten Nahphasen.
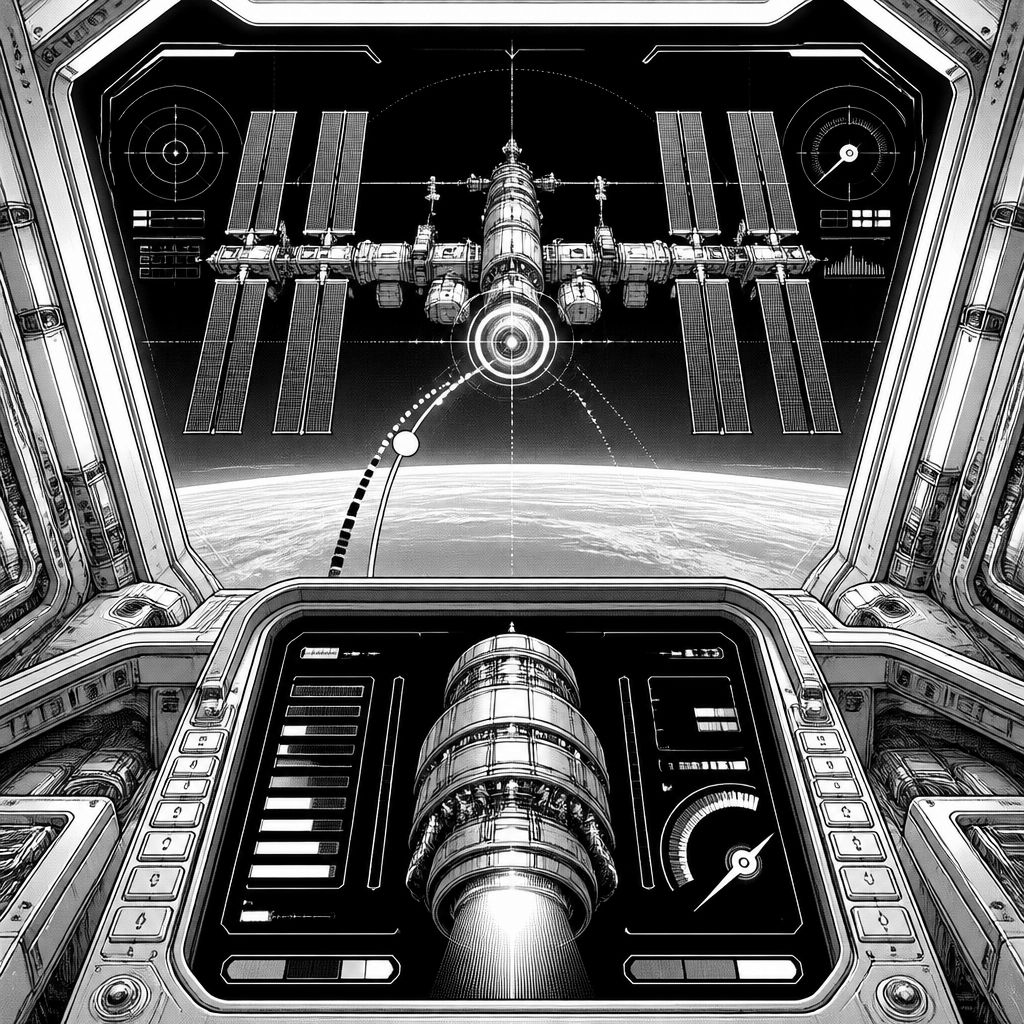
Andocken an der Internationalen Raumstation ist weniger ein mechanischer „Knopf-drücken“-Vorgang als ein Problem, das Raumfahrtingenieure seit Jahrzehnten wie einen präzisen Tanz behandeln: Man muss relative Bewegung, Bahnmechanik und Messunsicherheit gleichzeitig im Griff haben. Die Herausforderung wird besonders deutlich, wenn man sich die Geschwindigkeiten vor Augen führt, mit denen sich Ziel und Chaser bewegen. Eine falsche Beschleunigung zieht nicht nur „kurz“ von der Bahn ab, sie kann den gesamten Annäherungsprozess verschieben, während es im Vakuum auch keine natürliche Luftreibung gibt, die Korrekturen wieder dämpft. Genau hier setzt die neue Arbeit an, die auf arXiv als Preprint veröffentlicht wurde: Sie versucht, die Korrekturlogik nicht länger ausschließlich als harte Gleichungen plus Pilotenentscheidungen zu denken, sondern als KI-gestütztes Planungs- und Steuerungsverfahren auf Basis eines gelernten „World Models“.
Technisch baut der Ansatz auf einer realistischen Lücke in klassischen Navigationsketten. In der Praxis greifen Raumfahrzeuge im Low Earth Orbit häufig auf Guidance, Navigation and Control (GNC) zurück, ergänzt um Filter wie den Extended Kalman Filter: Der Filter verarbeitet Messdaten aus GPS-Empfängern und Sternsensoren zu Zustandsabschätzungen, aus denen sich wiederum Brennimpulse und Duty Cycles für die Triebwerke ableiten. Das zentrale Problem: Solche Filter und die damit verbundenen Zustandsmodelle sind nicht automatisch für jede Sensorik optimiert, vor allem nicht für hochauflösende, schnelle visuelle Streams. Sobald Lichtreflexe über eine Solarmodulfläche „glinten“ oder ein Zielbereich plötzlich in den Schatten rutscht, können klassische Computer-Vision-Pipelines aus dem Tritt geraten. Genau diese Robustheit gegen visuelle Störungen macht KI-Systeme attraktiv – aber Reinforcement Learning allein hat dabei oft einen Haken: Es lernt gut für Szenarien mit sehr konsistenten Regeln und toleriert Regelwechsel nur begrenzt.
Die Stanford-Ingenieure adressieren diesen Punkt über eine andere KI-Architektur-Philosophie: den Übergang von „Policy lernen wir für genau diese Regeln“ zu „Modell der Umwelt lernen wir aus Erfahrung“. In der Arbeit wird das „World Model“ als zentrales Konzept eingeführt. Als anschauliche Metapher dient ein Spieler im Outfield, der nicht sofort Gleichungen im Kopf löst, sondern mithilfe einer mentalen Simulation vorhersagt, wo der Ball landen wird. Übertragen auf maschinelles Lernen bedeutet das: Das Modell lernt die grundlegenden physikalischen Dynamiken der Umgebung nicht direkt aus programmierten Gleichungen, sondern aus Daten und Interaktionen, und nutzt diese gelernten Zusammenhänge, um mehrere mögliche Zukunftsverläufe zu „träumen“. Die Steuerung wird dann so ausgelegt, dass Ausgaben schrittweise auf ein gewünschtes Ziel hingeführt werden – und zwar nicht blind, sondern mit einer probabilistischen Bewertung der erwarteten Outcomes.
Damit wird auch ein zweiter Kernunterschied sichtbar: Das System soll nicht nur eine Antwort liefern, sondern Wahrscheinlichkeiten für Ergebnisse abschätzen. Diese Unsicherheitsschätzung ist für Proximity- und Rendezvous-Szenarien entscheidend, weil Annäherung nicht in einem einzelnen „Schuss“ endet. Stattdessen muss ein Controller in der Nähe des Zielobjekts iterativ nachregeln, wenn manche Annahmen nicht exakt zutreffen. Der Text beschreibt, dass der Lernweg dennoch hohe Rechenlast erfordert: Ein World Model braucht für das Training vergleichsweise viele simulierte Flüge, potenziell „hunderttausende“ Instanzen, um die Bandbreite der Dynamiken zuverlässig zu erfassen. Auf einer klassischen CPU-Umgebung wäre das laut den Angaben offenbar in Wochenbereich geraten. Deshalb entwickelt das Team eine GPU-beschleunigte Bibliothek namens AstroJAX, die das Training und die Simulation auf Grafikprozessoren ausrichtet – ein Ansatz, der an der Trainingslogik vieler moderner KI-Modelle anknüpft, jedoch auf astrodynamische Problemstellungen und spezifische Bild-/Sensorik-Schnittstellen zugeschnitten ist.
In den Resultaten wird das Potenzial des OWM (Out-of-this-World-Model) sehr konkret quantifiziert: Das Modell benötigt demnach 500.000 Iterationen, um Andockmanöver zu beherrschen. Ein vergleichbares Reinforcement-Learning-System kommt dagegen auf 25.000.000 Permutationen. Solche Größenordnungen sind in der Robotik-Entwicklung nicht nur „nice to have“, weil sie direkt darüber entscheiden, wie schnell man ein Verfahren experimentell iterieren, Stress-Tests einbauen oder eine neue Geometrie abdecken kann. Besonders praxisrelevant ist dabei der Hinweis, dass das OWM auch bei einem Docking-Port besser reagierte, der zuvor nicht vorkam. Zudem wurden unerwartete Situationen adressiert, etwa indem ein angedocktes „Capsule“-Objekt in den Bereich gebracht wurde, an den die KI eigentlich Schnittstellen erwarten sollte. Gerade solche Abweichungen sind im Orbitalltag plausibel: reale Missionen bewegen sich selten exakt innerhalb einer einzigen, perfekt vorausgesetzten Lehrbuchwelt.
Trotzdem bleibt der technische Reifegrad noch begrenzt. Über alle Docking-Ports der ISS hinweg erreichte das Modell im beschriebenen Setup etwa 53% Erfolgsrate. Die Vergleichsbasis aus dem Reinforcement Learning lag bei 29%. Das ist ein klarer Vorteil, aber zugleich zeigt die Zahl, dass es weiterhin Situationen gibt, in denen der Controller nicht zuverlässig genug „sitzt“, insbesondere bei Close-up-Operationen. Als plausible Erklärung führen die Autorinnen und Autoren eine hohe Strafgewichtung für Kollisionen an: Wenn das Belohnungsschema Kollisionen sehr stark ahndet, kann das zu konservativen Manövern führen, die zwar sicherheitsrelevant sind, aber weniger effektiv auf eine enge Zielposition zulaufen. Wichtig ist an dieser Stelle: Solche Gewichtungen lassen sich in nachfolgenden Iterationen anpassen – und genau an dieser Stelle liegt eine naheliegende Engineering-Strecke, um die Trade-offs zwischen Risiko, Zielgenauigkeit und Dynamikgeschwindigkeit zu optimieren.
Für den Markt und die Industrie ist die Entwicklung mehr als eine akademische Demonstration, weil sich die Nutzungslandschaft im Orbit verschiebt. Immer mehr Satelliten müssen gewartet, umgeroutet oder perspektivisch de-orbited werden; daneben wächst auch die Zahl bemannter bzw. nahe bemannter Aktivitäten. In solchen Umgebungen steigt der Bedarf an autonomen, robusten Proximity-Funktionen, die nicht jedes Mal auf identische Bedingungen trainiert wurden. Das OWM zielt dabei nicht auf „vollautomatisch ab Tag eins“, sondern auf eine schrittweise Annäherung: Zuerst könnten KI-Systeme Teile der Entscheidungsfindung übernehmen, etwa die Wahrscheinlichkeitsbewertung und Trajektorienplanung, während menschliche Operatoren weiterhin Gatekeeper bleiben. Gleichzeitig zeigt der Ansatz, wie KI-Methoden aus der Spielewelt (GPU-Training) und aus moderner Robotik (World-Modeling statt starrer Regelwerke) zusammengeführt werden können, um ein Sicherheitskritisches Problem wie das Docking stärker aus der engen Schablone zu lösen. Wer KI in Raumfahrtprozesse integrieren will, sollte dabei vor allem auf die kombinierte Kette aus Simulation, Sensorrobustheit und probabilistischer Regelung achten – denn genau dort entscheidet sich, ob ein System im Labor gut wirkt oder im Orbit wirklich belastbar ist.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Stanford entwickelt KI-World-Model für autonomes Rendezvous an der ISS" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Stanford entwickelt KI-World-Model für autonomes Rendezvous an der ISS" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Stanford entwickelt KI-World-Model für autonomes Rendezvous an der ISS« bei Google Deutschland suchen, bei Bing oder Google News!