
GHENT / LONDON (IT BOLTWISE) – Forschende zeigen mit fMRT-Messungen, dass das Gehirn emotionale Informationen aus Mimik und Stimme nicht strikt getrennt verarbeitet. Face- und voice-selektive Regionen tragen demnach überlappende Codes: Bestimmte Areale spiegeln dieselbe Emotion sowohl beim Sehen als auch beim Hören wider. Entscheidend ist außerdem, dass die gleichzeitige Stimulation nicht nur „addiert“, sondern die neuronale Aktivität in sozialen Netzwerken neu organisiert. Das schafft eine bessere Grundlage, um Unterschiede in der multimodalen Emotionsverarbeitung bei neuroentwicklungsbezogenen Bedingungen zu untersuchen.
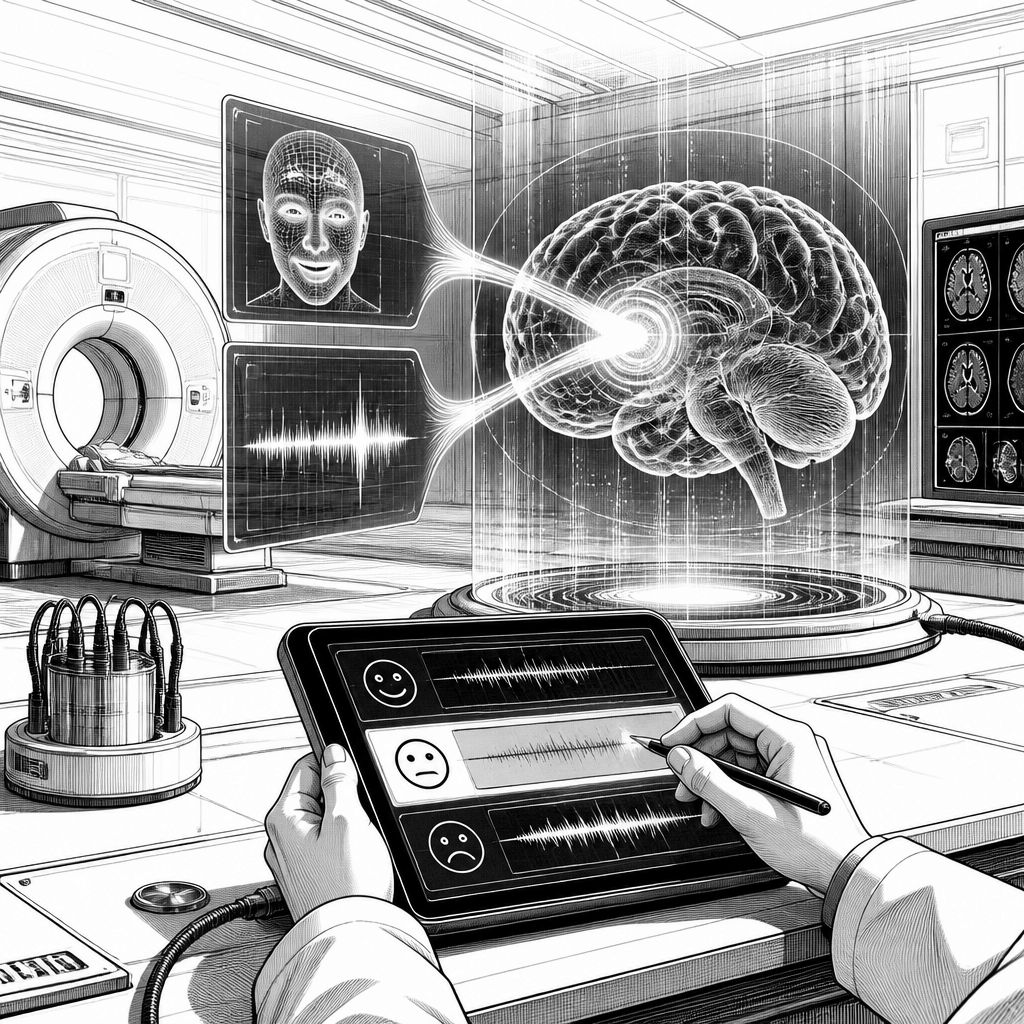
Emotionen sind selten eindimensional. Wer einer Person in die Augen schaut, bewertet dabei nicht nur die sichtbare Mimik, sondern auch die Prosodie, also Tonfall und Rhythmus der Sprache. In der kognitiven Neurowissenschaft war die zentrale Frage bislang, ob das Gehirn solche Informationen zunächst strikt nach Sinnesmodalitäten trennt und sie anschließend „zusammenbaut“ – oder ob es bereits auf früheren Verarbeitungsebenen einen gemeinsamen, über Sinnesgrenzen hinweg gültigen Emotionscode nutzt. Eine Studie, die in der Journal of Neuroscience veröffentlicht wurde, liefert dafür vergleichsweise direkte Evidenz und rückt ein differenziertes Bild sozialer Hirnnetzwerke in den Fokus: Gesicht und Stimme wirken nicht wie zwei unabhängige Datenströme, sondern wie zwei Zugriffspfade auf dieselbe Bedeutungsebene.
Den Kern der Arbeit bildet ein Cross-Sensory-Ansatz mit funktioneller Magnetresonanztomographie (fMRT). Die Forschenden um Olivier Collignon (Catholic University of Louvain) und Stefania Mattioni (damals am Projekt, später an der Ghent University) ließen Teilnehmende emotionale Gesichter, emotionale vokale Äußerungen oder beide gleichzeitig wahrnehmen. Dabei zeigten sich in der alleinmodalen Betrachtung zunächst die erwartbaren Aktivierungsmuster: Emotionsinhalte aus Mimik und Prosodie lösten jeweils in weiten Bereichen Aktivität aus, die auf spezialisierte Sinnescortices und sozial relevante Verarbeitungswege hinweist. Überraschend war jedoch, dass diese Signaturen nicht starr auf den „eigenen“ Sinnesbereich begrenzt blieben. Mattioni formuliert es in der Studie so: „Importantly, these areas were not limited to their preferred sense: Several face-selective regions also carried information about emotions heard in voices, while voice-selective regions carried information about emotions seen in faces“, und weiter: „In some regions, the brain even represented the same emotion similarly whether it was seen or heard.“
Damit verschiebt sich die Interpretation von reiner Sinnesphysik hin zu einer abstrakteren Repräsentation. Die Studie beschreibt, dass bestimmte Kortizes emotionale Zustände in einem ähnlichen „Format“ kodieren, unabhängig davon, ob der Input über Augen oder Ohren kommt. Anders gesagt: Das Gehirn behandelt „Furcht“ oder „Freude“ nicht nur als Muster visueller Geometrien oder als akustische Frequenzverteilung, sondern als ein Konzept, das über Modalitäten hinweg wiedererkennbar bleibt. Genau diese sensorische Invarianz ist technologisch interessant, weil sie nahelegt, dass es in der Verarbeitung nicht nur um Feature-Extraktion geht (z. B. Augenform, Mundwinkel, Stimmhöhe), sondern um eine Ebene, die Bedeutung stabil macht. Für die Modellierung menschlicher Kommunikation wäre das ein Hinweis darauf, dass Systeme zur Emotionsdetektion nicht zwangsläufig zwei vollständig getrennte Klassifikationsräume brauchen, sondern möglicherweise eine gemeinsame Bedeutungsschicht mit modal-spezifischen „Eingängen“.
Noch deutlicher wird der Punkt beim Vergleich der Bedingungen „Gesicht allein“ und „Stimme allein“ versus „Gesicht plus Stimme“: Die neuronale Antwort wird nicht einfach in der Summe beider Sinneseindrücke aufgeholt. Die Forschenden berichten vielmehr, dass die simultane Präsentation von emotionalen Gesichtern und vokalen Ausdrucksformen die Aktivität in sozialen und emotionalen Netzwerken dynamisch umstrukturiert. Praktisch heißt das: Die Kopplung über Modalitäten dient nicht nur der Plausibilisierung, sondern der eigentlichen Neubewertung. Ein solcher Mechanismus erklärt, warum Menschen in realen Situationen mit widersprüchlichen oder unklaren Signalen schneller zu einem stabilen Eindruck kommen können. Wenn Mimik und Prosodie zusammenpassen, können multimodale Netzwerke die eingehenden Informationen abgleichen, Zeit gewinnen und soziale Urteile feinjustieren – etwa bei der Einschätzung von Bedrohung, Absicht oder Sympathie, selbst wenn ein Signal durch Entfernung, schlechtes Licht oder Hintergrundlärm schlechter wird.
Aus Sicht der Neuroentwicklung eröffnet diese Art von Ergebnis außerdem einen konkreten Rahmen für Diagnostik und Intervention. In neuroentwicklungsbezogenen Bedingungen wie Autismus-Spektrum-Störung oder sozialen Kommunikationsschwierigkeiten fällt es Betroffenen häufig schwer, komplexe multimodale Umwelten konsistent zu interpretieren. Die Studie arbeitet dabei mit dem Gedanken, dass sich aus der Identifikation der kortikalen Knotenpunkte, in denen die Integration von Emotionscodes stattfindet, ableiten lässt, wo der „Binding“-Prozess eventuell schwächer, verzögert oder anders organisiert ist. Für zukünftige Werkzeuge bedeutet das: Statt nur einzelne Sinneskanäle isoliert zu betrachten, könnten Diagnostik- und Trainingsansätze stärker darauf zielen, die Kopplung zwischen Sicht- und Höreindrücken messbar zu verbessern. In der Praxis wäre das etwa die Gestaltung von Lernumgebungen, die gezielt die zeitliche Abstimmung von Mimik und Prosodie adressieren und die Nutzer nicht nur auf ein Signal trainieren.
Auch für die weitere Forschung bleibt die Richtung klar, weil der Ansatz an einer vergleichsweise präzisen Messlogik ansetzt: fMRT zeigt, welche Hirnareale gemeinsam Aktivität signalisieren, und die Analysen zur sensorischen Invarianz lassen Rückschlüsse auf repräsentationale Ähnlichkeiten zu. Gleichzeitig ist es wichtig, die Grenzen solcher Befunde sauber zu sehen: Die Studie kartiert neuronale Muster im Labor-Setting, während echte soziale Interaktion zusätzlich durch Körperhaltung, Blickrichtung, Kontext und Dynamik geprägt ist. Dennoch liefert die Arbeit einen belastbaren Hinweis, dass „Emotion lesen“ im Gehirn nicht als nachträgliches Verknüpfen zweier isolierter Kanäle funktioniert, sondern als über Modalitäten hinweg konsistenter Codeswitch. Genau an dieser Stelle könnten kommende Studien ansetzen, um die Integrationsprozesse zeitlich genauer zu entkoppeln und damit auch die Brücke zu verhaltensnahen Messgrößen zu schlagen.
Für Unternehmen und Forschungsteams, die KI-gestützte Systeme zur Emotions- oder Kommunikationsanalyse entwickeln, ist die Botschaft damit zweischichtig: Erstens kann die multimodale Integration nicht durch triviales „Zusammenführen“ von Audio- und Bildfeatures ersetzt werden. Zweitens lohnt sich die Suche nach einer gemeinsamen Repräsentation, die über Sinnesgrenzen hinweg stabile Bedeutungsdimensionen bildet. Das ist nicht nur ein konzeptionelles Thema, sondern beeinflusst Architekturentscheidungen in der KI-Entwicklung: von der Art der Trainingsziele bis hin dazu, wie Modelle Inkonsistenzen zwischen Gesicht und Stimme behandeln. Wenn das Gehirn in sozialen Netzwerken die Codes bereits über Modalitäten hinweg invariant repräsentiert, dann sind robuste KI-Designs vermutlich jene, die diese Art von Bedeutungskopplung explizit unterstützen – statt nur Modalitäten parallel laufen zu lassen.


💳 Amazon-Kreditkarte mit 2.000 Euro Limit bestellen!
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.






- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "Wie das Gehirn Sehen und Hören verschmilzt, um Emotionen zu lesen" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "Wie das Gehirn Sehen und Hören verschmilzt, um Emotionen zu lesen" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »Wie das Gehirn Sehen und Hören verschmilzt, um Emotionen zu lesen« bei Google Deutschland suchen, bei Bing oder Google News!